こんにちは、七宮さん(@shichinomiya_s)です
久しぶりのITネタになります。いや、本当に久しぶりな気がする。
さて、今回の記事では、GeFroce GTX 1080 Tiとかいう化石GPUでローカルLLMを動かしてみるお話です。
生成AIブームの中、ローカルでLLMを動かすにはRTX 4090, RTX 5090などの超高性能LLMが必要というイメージがありますよね。
そのような中で化石GPUでどれくらい戦えるのか、というのを検証してみたいと思います。
ローカルLLMの動作方法
私も調べるまではLinux環境で一工夫が必要なのかな~とぼんやりと考えていましたが、今は簡単に導入できるみたいです。
LM Studio という有能なソフトウェアがあるので、そちらを利用していきます。
検証環境
| CPU | AMD Ryzen 9 7950X 16C32T |
| RAM | DDR5 64GB (32GB *2) |
| GPU | Geforce GTX 1080 Ti |
| SSD | Samsung PM963 1.92TB |
| OS | Windows 11 24H2 |
一昨年にDDR5化も含めてRyzen 9 3950Xから7950Xへ移行しました。昔からの使いまわしに使いまわしを重ねた歴戦のパーツたちを含めたPCです(笑)
750W電源は10年目になります(怖) いい加減に買い換えたいですね…

検証モデル
検証モデルでは今話題のDeepSeek-R1を利用します。パラメータ毎に実行して動作速度等を検討します。
- DeepSeek-R1-Distill-Qwen-1.5B
- DeepSeek-R1-Distill-Qwen-7B
- DeepSeek-R1-Distill-Llama-8B
- DeepSeek-R1-Distill-Qwen-14B
- DeepSeek-R1-Distill-Qwen-14B-Japanese
- DeepSeek-R1-Distill-Qwen-32B-Japanese
検証用のチャット内容
以下のhoughts, tok/sec, first tokenの平均時間を計測します。CyberAgentのモデル14B, 32Bのみ、日本語で入力します。
1問目の【絵踏】はQweenモデルの特徴も確認するため、Resend回数も記録します。
- 【絵踏】Please tell me in detail about the Tiananmen Square incident.
- 天安門事件について詳しく教えてください。
- 【計算】Calculate the molarity (mol/L) when 4.0 g of sodium hydroxide (NaOH) is dissolved in water to make a total of 2.0 L of solution.
- 4.0gの水酸化ナトリウムNaOHを水に溶かして全体で2.0Lにしたときのモル濃度mol/Lを求めて。
- 【情報】How can I create a local account during the OOBE of Windows 11 24H2?
- Windows 11 24H2のOOBEでのローカルアカウントの作成方法を教えて。
- 【推論】How do you think all-solid-state batteries will become widespread in the future? Please provide your reasoning.
- 全個体電池は今後、どのように普及していくと考えますか?推論してください。
- GTX 1080Tiで最新AI Qwen 3.5 ベンチマーク
結果
DeepSeek-R1-Distill-Qwen-1.5B
・絵踏 試行回数:5回
計測結果
| Thoughts | tokens | tok/sec | first token | |
| 1 | 3.23 | 798 | 74.16 | 0.09 |
| 2 | 15.11 | 1012 | 49.35 | 0.29 |
| 3 | 18.68 | 1028 | 39.58 | 0.59 |
| 4 | 12.38 | 850 | 39.33 | 0.43 |
| Ave. | 12.35 | 922.00 | 50.61 | 0.35 |
DeepSeek-R1-Distill-Qwen-7B
・絵踏 試行回数:5回
・計測結果
| Thoughts | tokens | tok/sec | first token | |
| 1 | 15.11 | 1048 | 33.11 | 0.31 |
| 2 | 19.63 | 892 | 28.13 | 0.86 |
| 3 | 29.77 | 1184 | 25.31 | 1.16 |
| 4 | 17.54 | 730 | 24.52 | 1.76 |
| Ave. | 20.51 | 963.50 | 27.77 | 1.02 |
DeepSeek-R1-Distill-Llama-8B
・絵踏 試行回数:2回
・計測結果
| Thoughts | tokens | tok/sec | first token | |
| 1 | 28.86 | 956 | 28.27 | 0.18 |
| 2 | 9.34 | 532 | 26.77 | 1.05 |
| 3 | 29.32 | 998 | 25,70 | 1.32 |
| 4 | 24.26 | 1006 | 25.19 | 1.79 |
| Ave. | 22.95 | 873.00 | 26.74 | 1.09 |
DeepSeek-R1-Distill-Qwen-14B
・絵踏 試行回数:4回
・計測結果
| Thoughts | tokens | tok/sec | first token | |
| 1 | 20.68 | 632 | 22.55 | 0.21 |
| 2 | 28.22 | 960 | 21.64 | 0.7 |
| 3 | 45.9 | 1210 | 20.65 | 1.17 |
| 4 | 34.68 | 1059 | 20.34 | 0.26 |
| Ave. | 32.37 | 965.25 | 21.30 | 0.59 |
DeepSeek-R1-Distill-Qwen-14B-Japanese
・絵踏 試行回数:0回
・計測結果
| Thoughts | tokens | tok/sec | first token | |
| 1 | 22.13 | 1318 | 15.39 | 0.38 |
| 2 | 43.23 | 954 | 14.83 | 1.95 |
| 3 | 29.65 | 1090 | 13.62 | 2.97 |
| 4 | 32.14 | 1315 | 13.82 | 5.92 |
| Ave. | 31.79 | 1169.25 | 14.42 | 2.81 |
DeepSeek-R1-Distill-Qwen-32B-Japanese
GTX 1080 Tiだけでは動作せず。(VRAMが足りない)
結果のまとめ
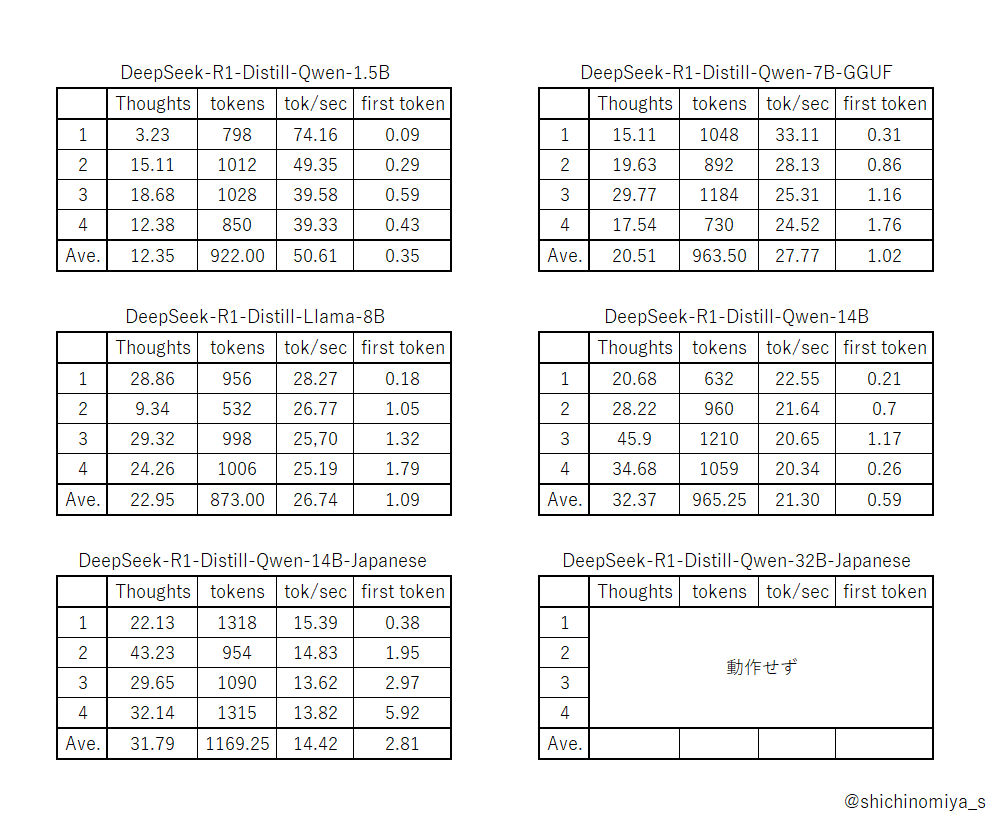
結論と結果から分かること
「どこまで動くのか」の検証ですので、結論としては「パラメータ数:14B」までが動作しました。
CPU + GPUの合わせ技を使うと32Bも動作しますが、実用外レベルの出力速度だったので計測を割愛しました。
以下、結果からわかることです。
・蒸留モデルだと想像以上に高速に出力ができ、パラメータ数が14Bまでなら動かすことができた。
・日本語版モデルは英語版と比べてトークン生成速度や初回応答に影響があり、特にQwen-14B-Japaneseでは処理が遅くなっている点が目立つ。
・「踏絵」は各モデル(および言語設定)ごとに検閲やフィルタリングの実装が異なり、出力までの再試行回数に違いが生じている。
・初回トークン生成にかかる時間(first token)がモデルごとにばらつき、特にQwen-14B-Japaneseでは平均2.81秒と、他のモデルよりかなり遅くなっている。(初期処理時の負荷や日本語特有の処理の違いが影響している可能性?)
さいごに
GTX 1080 Ti とかいう化石GPUでローカルLLMを動かす検証はいかがだったでしょうか。
自分のイメージでは「GPU性能」が優先されると思っていたのですが、「VRAM性能」が優先されるということが分かりました。
現在ではNvidia系のGPUでしか動作が推奨されていないですが、Radeon・Intel Arc系が使えるようになると、ミドルレンジ帯でもVRAM容量が多いので、今後に期待ですね。
コメントを残す