【費用0円】エプソンの廃インク限界エラーを無料解除!EP-804Aを自力リセットした全手順
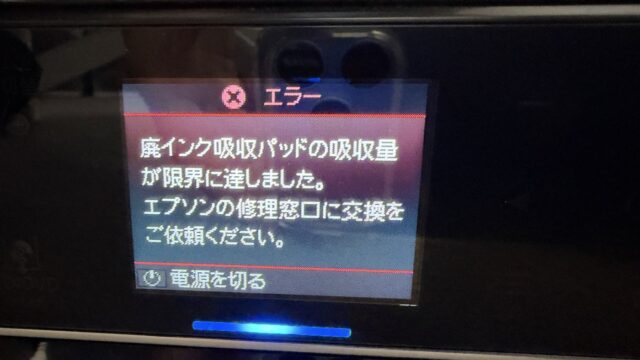
修理受付が終了したEPSON EP-804Aの「廃インク吸収パッドの吸収量が限界に達しました」エラーを、無料のオープンソース「EWR」で解除。起動しないときの対処、dry runとバックアップを挟んだ安全な手順を、実際のログ付きで解説します。
修理受付が終了したEPSON EP-804Aの「廃インク吸収パッドの吸収量が限界に達しました」エラーを、無料のオープンソース「EWR」で解除。起動しないときの対処、dry runとバックアップを挟んだ安全な手順を、実際のログ付きで解説します。
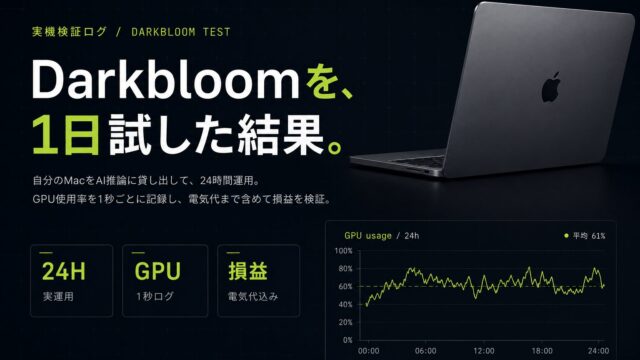
余ってるMacをDarkbloomのAI推論ノードとして貸し出すと本当に稼げるのか、MacBook Pro / M1 Max / 64GBで丸1日検証。公式試算は月75ドルですが、実測の24時間収益は0.60ドルで中身はほぼ基本報酬だけ。GPU使用率ログと実測電気代(0.36kWh/日)から損益まで正直に出しました。
AIエージェントのトークン消費を最大95%削減すると謳うOSS「Headroom」を実際にMacへ導入し、ログ・JSON・コード・RAGの4種データで実測。コード79.8%・JSON59.2%・ログ31.0%削減、多段デバッグセッション全体では47.5%削減を確認しました。導入手順から仕組み、コスト試算、向き不向きまで正直にレビューします。
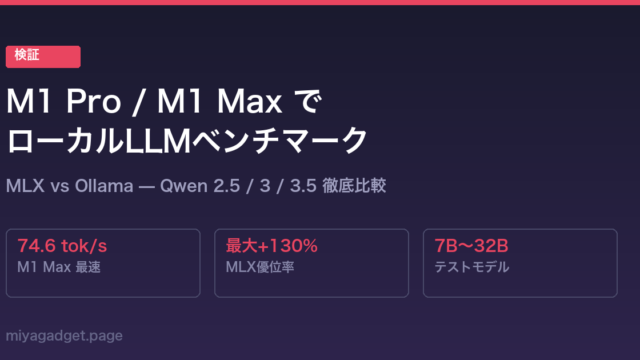
Apple M1 Pro(32GB)とM1 Max(64GB)で最新ローカルLLM「Qwen 2.5/3/3.5」をベンチマーク。MLX-LMとOllamaの速度比較、4bit/8bit量子化の違い、GTX 1080Tiとの三つ巴比較まで徹底検証。M1 Max + MLX 4bitでQwen 3.5 9Bが56.9 tok/sを記録しました。
GTX 1080Tiで最新の生成AI「Qwen 3.5 9B」がどこまで動くか検証しました。Q4_K_MとQ8_0の2つの量子化で速度・品質を比較。11GB VRAMの古いGPUでもローカルLLMは実用的に使えるのか、ベンチマーク結果を徹底解説します。
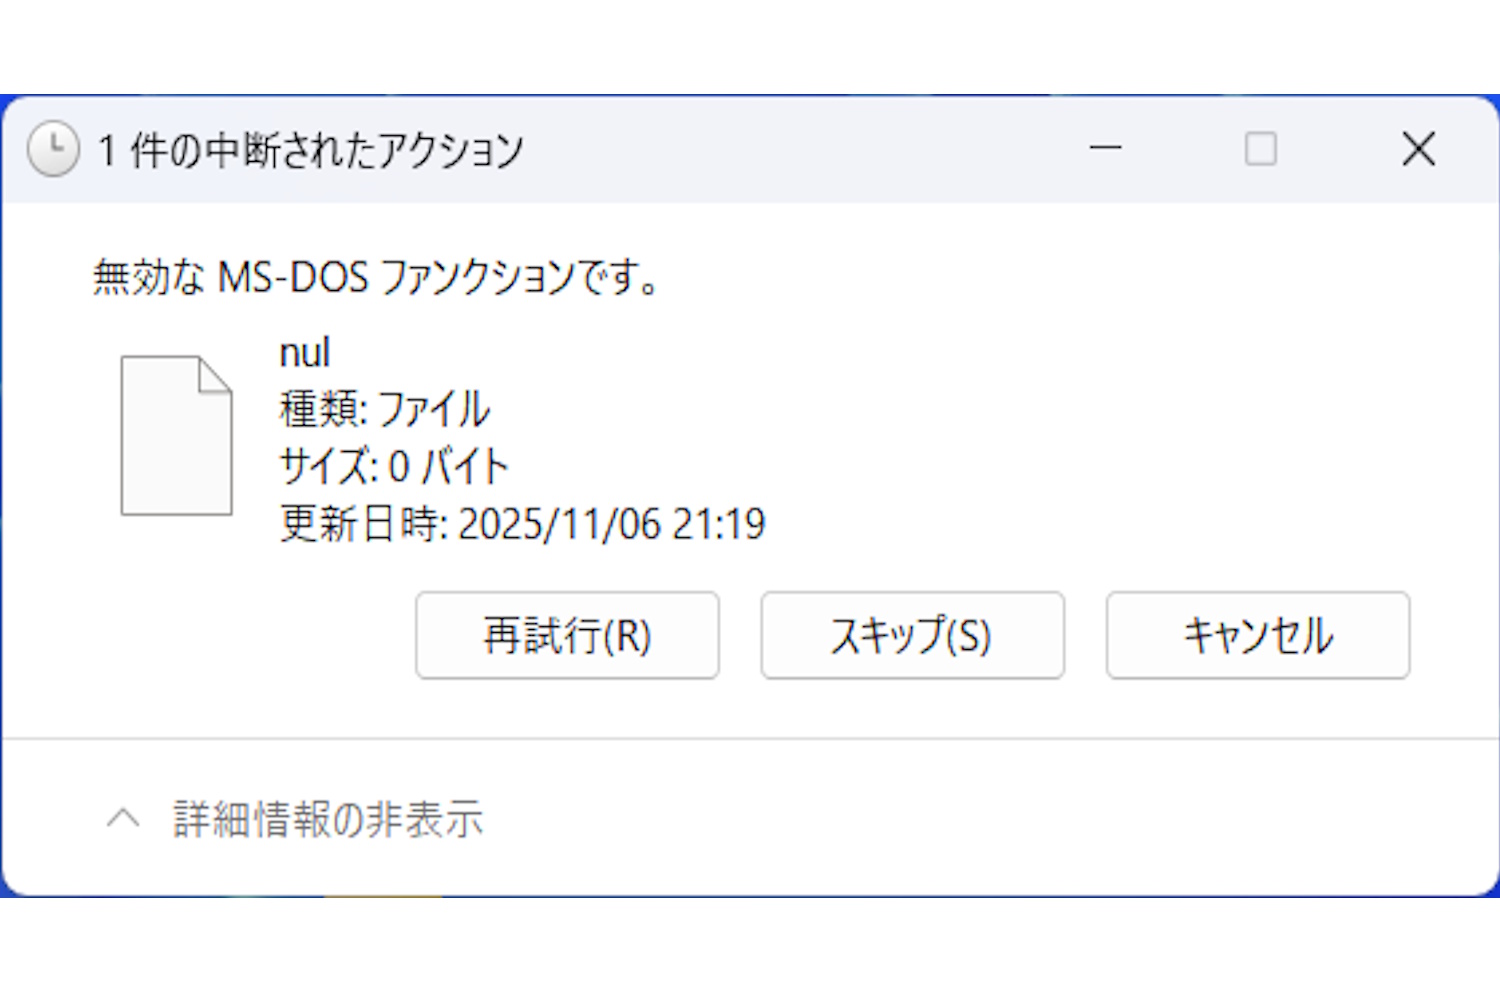
今回の記事では、Claude Code on Windows にて稀に作られる「nul」ファイルの削除方法について書いてみたいと思います。 Claude Code は非常に便利なツ…
今回の記事では、FlaskベースでモバイルファーストなWeb会計アプリケーションを構築したお話を書こうと思います。American Expressのクレジットカード明細を手動でイン…
先日、DELLのハイエンドモニターを購入し、デイジーチェーン接続を試してみたところ、想像以上に奥が深く、沼にハマりました。 今回、調べた内容を備忘録としてまとめました。Displa…
これまでLevel 2からLevel 9まで、様々なアプリケーションを作ってきました。今回は集大成として、これまで学んだ技術を全て活用した「本格的なブログシステム」を構築します。 …
これまでPDFレポート生成まで作ってきましたが、今回は「メール送信の自動化」に挑戦します。定期的に送るメールや、条件に応じて自動送信するシステムを作ってみました。 今回作るもの:メ…