こんにちは、七宮さん(@shichinomiya_s)です。
前回はTesla V100 32GBでQwen3.8-27Bを動かしましたが、今回はその続きです。同じ「VRAM 32GB」でも、中身がまったく違うカードを手に入れました。中国で出回っているRTX 4080の32GB改造品です。本来16GBのRTX 4080基板にGDDR6Xチップを増設して32GB化したもので、「RTX 4090 48GB」や「RTX 2080 Ti 22GB」と同じ系譜のハードウェアモッド品です。最近は海外の中古市場でもまとまった数を見かけるようになりました。
最大の焦点は、「VRAM容量は倍になったが、メモリバス幅もGPUコアも元の16GB版のまま」という点です。メモリ帯域が据え置きのまま容量だけが増えた時、何ができるようになり、何が変わらないのか。前回のV100記事と同じモデル・同じ測定条件で比較することで、同じ32GBでもアーキテクチャの違いによってどう差が出るのかを検証しました。
検証対象は以下の3本です。
- Qwen3.8-27B(dense 27B):量子化別の推論速度、コンテキスト長スケーリング、16GB/24GB制限時の挙動
- Qwen3.8-Flash-Next(125B-A6B MoE):32GBに収まらない巨大モデルをメインメモリへ部分オフロードして実行
- MiniMax H3:音声生成を統合したDiTベースの動画生成モデル
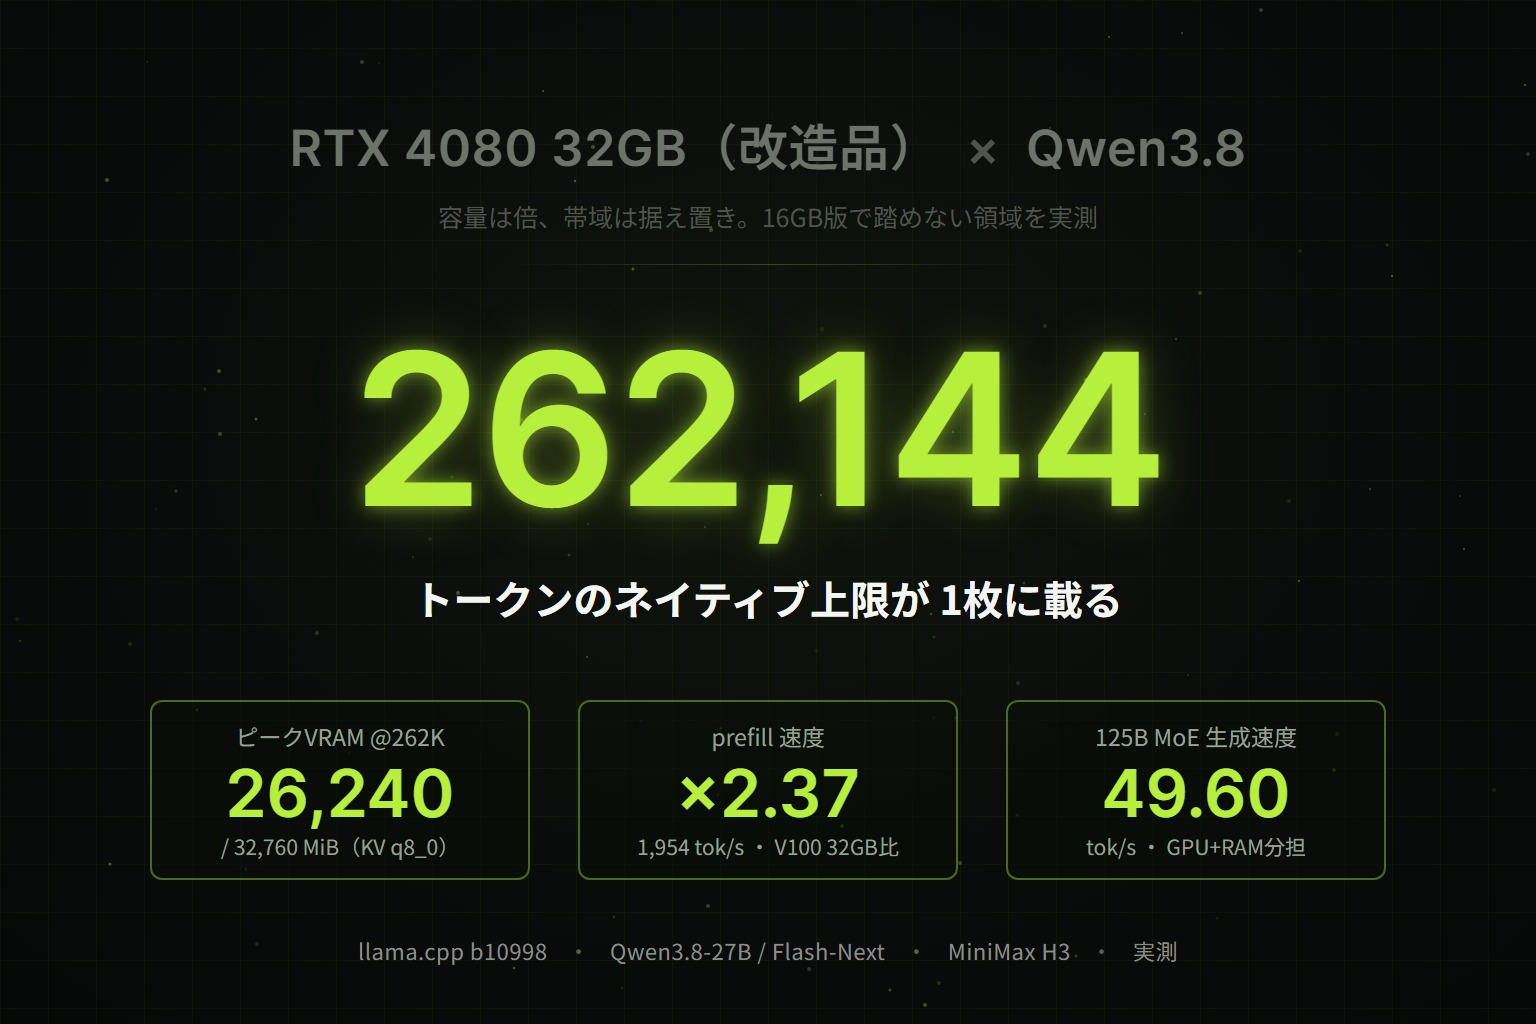
先に結論を言えば、本カードは「生成速度は16GB版と同等のまま、収容できるモデルやコンテキストの限界線だけを大きく押し広げるカード」でした。Qwen3.8-27B(Q4_K_XL)の生成速度は34.98 tok/sと、公称帯域で勝るV100(33.41 tok/s)とほぼ同等です。その一方で、24GBカードでは溢れるQ8_0(27.04 GiB)が全層GPUに収まり22.47 tok/s(24GB制限時は7.31 tok/s)で動作し、ネイティブ上限の262,144トークンもKV q8_0併用で26,240 MiBに収まりました。prefill速度もV100比で2.4〜3.2倍に達しています。他方、MiniMax H3のような動画生成では16GB相当に絞っても生成速度がほぼ変わらず、VRAMがわずかでも溢れるとエラーを出さずにサイレントに極端な速度低下を起こすなど、改造品特有のクセも見えてきました。
本記事の数値はすべて手元の実機で計測したログに基づいています。想定通りにいかなかった挙動も含め、そのまま記録します。
実測サマリー
| 項目 | 実測値 |
|---|---|
| 生成速度(Qwen3.8-27B UD-Q4_K_XL・深度0) | 34.98 tok/s(V100 32GB: 33.41 tok/s) |
| prefill(同) | 1,954.03 tok/s(V100の2.37倍) |
| Q8_0を全層GPU | 22.47 tok/s / 29,012 MiB(24GB相当 7.31・16GB相当 3.17 tok/s) |
| 262,144トークン(KV q8_0) | 17.24 tok/s / 26,240 MiB |
| 10万トークンの資料読解 | 104,955トークンを84.8秒で処理して正解 |
| Qwen3.8-Flash-Next(125B MoE・UD-Q2_K_XL) | メインメモリと分担して最大49.60 tok/s |
| MiniMax H3(1344×768・5秒・turbo 4step) | 150.1秒(16GB相当に絞っても150.2秒) |
| VRAM全域テスト(memtest_vulkan) | エラー0 |
| 20分連続生成 | 22.38〜22.41 tok/sで安定 / メモリジャンクション最高82.0℃ / サーマルスロットリングなし |
| ピーク電力 | 321.08 W |
運用のポイント:長大なコンテキストを扱う際は
-ctk q8_0 -ctv q8_0の指定が必須です。262,144トークンの場合、デフォルトのf16ではメモリ溢れにより30分経っても完了しませんでしたが、q8_0であれば全体の計測が6分25秒で終了し、17.24 tok/sで安定動作しました。
RTX 4080 32GB改造品の仕様 — 容量は倍、帯域は据え置き
通常のRTX 4080は、基板表面に2GBのGDDR6Xチップを8枚配置して16GBを構成しています。本改造品は基板裏面にも同容量のチップを実装するクラムシェル配置によって32GB化されたものです。GPUダイ(AD103)自体は変更されていないため、CUDAコア数もメモリバス幅も純正品と同一です。変わるのはあくまで格納できる容量だけで、転送帯域幅(716.8 GB/s)は変わらない、というのがハードウェア上の基本設計です。
| 項目 | RTX 4080(純正) | 今回の個体 |
|---|---|---|
| GPU | AD103(Ada Lovelace / sm_89) | 同じ(Device ID 0x2704) |
| CUDAコア | 9,728 | 同じ |
| VRAM | 16GB GDDR6X | 32,760 MiB(nvidia-smi表示) |
| メモリバス / 速度 | 256bit / 22.4Gbps(理論帯域716.8GB/s) | 同じ(メモリクロック上限11,201MHz) |
| 電力上限 | 320W | 320W |
| PCIe | Gen4 x16 | Gen4 x16(負荷時に確認) |
| BAR1(Resizable BAR領域) | — | 16,384 MiB |
比較対象のTesla V100 32GBはHBM2を採用しており、メモリ帯域は約900 GB/sに達します。カタログスペック上の帯域ではV100のほうが太い構成です。LLMの生成フェーズはメモリ帯域が主なボトルネックとなるため、「同じ32GB同士であればV100と同等か、むしろ遅いのではないか」という懸念もありました。ここが今回の重要な検証ポイントです。
なお、表の最下行にある通り、BAR1が16,384 MiBにとどまっている点は改造品ならではの特徴です。VRAM全体としては32GBと認識されているものの、CPUから直接参照できるアパーチャサイズは元の16GB版の設定を引きずっています。この点の実用上の影響についても後述します。
> nvidia-smi --query-gpu=name,vbios_version,driver_version,memory.total,power.limit,pcie.link.gen.max,pcie.link.width.max --format=csv
name, vbios_version, driver_version, memory.total [MiB], power.limit [W], pcie.link.gen.max, pcie.link.width.max
NVIDIA GeForce RTX 4080, 95.03.33.40.5e, 616.56, 32760 MiB, 320.00 W, 4, 16

> nvidia-smi -q -d MEMORY
    FB Memory Usage
        Total                                          : 32760 MiB
        Reserved                                       : 392 MiB
    BAR1 Memory Usage
        Total                                          : 16384 MiB
        Used                                           : 16355 MiB
        Free                                           : 29 MiB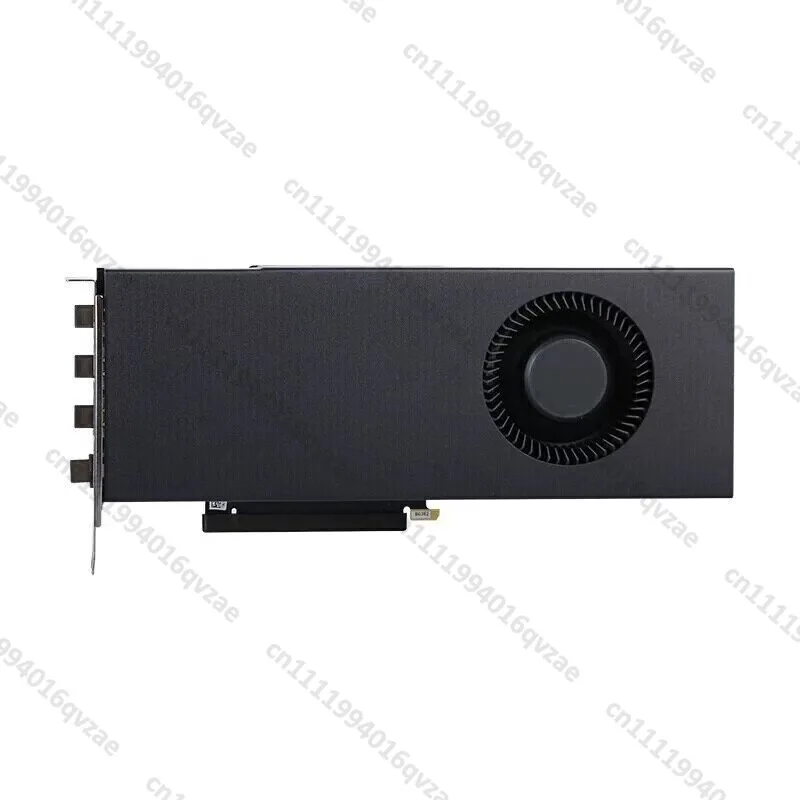
検証環境
| 項目 | 内容 |
|---|---|
| GPU | NVIDIA GeForce RTX 4080 32GB(改造品・シングルファン) |
| ドライバ | 616.56(CUDA 13.4) |
| CPU | AMD Ryzen 9 9950X(16コア32スレッド) |
| メモリ | DDR5-4800 32GB×2(64GB) |
| マザーボード | ASUS TUF GAMING X670E-PLUS WIFI |
| ストレージ | Samsung PM963 1.92TB(NVMe) |
| OS | Windows 11 Pro(build 26200) |
| LLMランタイム | llama.cpp b10998(37b53fd45)公式Windows CUDA 13.4ビルドをそのまま使用 |
| 動画生成 | ComfyUI 0.33.0 / PyTorch 2.13.0+cu130 |
| 計測方法 | llama-bench を -r 3(深度131,072以上は -r 1)。VRAM・電力・温度は nvidia-smi の1秒粒度ログのピーク値 |
ディスプレイ出力はCPU内蔵のRadeon側に接続しており、RTX 4080は描画処理に使用していません。そのため、測定されたVRAM消費量にデスクトップUIのオーバーヘッドは含まれていません。
前回のV100記事ではVolta世代がサポート外となったため自前でのビルドが必要でしたが、Ada Lovelace(sm_89)であれば公式配布のWindows向けバイナリを展開するだけで動作します。環境構築のハードルという点では大きな違いです。
なお、本個体は標準のファン制御がやや不安定だったため、メモリジャンクション温度に連動して回転数を調整する自作スクリプトを常駐させた状態で測定を行っています。
検証結果① 32GBメモリの健全性 — 全域テストでエラー0、24GB確保時も帯域は維持
改造グラフィックカードを扱う上で最初に確認すべきは、「表示通りの32GBが物理的に正常動作しているか」です。VBIOSの書き換えで認識だけを偽装し、上位アドレスへの書き込み時にデータが破損する個体も存在し得ます。GeForceはECC非対応のため、メモリエラーが発生してもOS側で検知できず、サイレントにデータが化けるリスクがあります。
そこで memtest_vulkan(v0.5.0)を使用し、VRAM全域の読み書きテストを行いました。
Standard 5-minute test of 1: Bus=0x01:00 DevId=0x2704   32GB NVIDIA GeForce RTX 4080
      1 iteration. Passed  0.0851 seconds  written:   25.4GB 637.5GB/sec        checked:   29.0GB 640.4GB/sec
    423 iteration. Passed 30.0324 seconds  written: 8957.4GB 639.4GB/sec        checked:10237.0GB 638.9GB/sec
   (中略)
   3247 iteration. Passed 30.0204 seconds  written: 8957.4GB 639.6GB/sec        checked:10237.0GB 639.2GB/sec
Standard 5-minute test PASSed! Just press Ctrl+C unless you plan long test run.
テスト中のVRAM使用量は30,441 MiBに達しましたが、標準テスト(3,247イテレーション)をエラー0で通過。読み書き速度も約639 GB/sで最後まで安定していました。
続いてPyTorchを用いてGPU内のメモリコピー速度と、CPU↔GPU間の転送速度を測定しました。増設された上位16GB領域の実効速度を確かめるため、あらかじめ24GiBのテンソルを確保して埋めた状態でも同様の測定を行っています。
| 項目 | 空の状態 | 24GiB確保した状態 |
|---|---|---|
| GPU内コピー(D2D、読み+書き換算) | 601.0 GB/s | 599.9 GB/s |
| CPU→GPU転送(pinned) | 26.8 GB/s | 26.8 GB/s |
| GPU→CPU転送(pinned) | 26.3 GB/s | 26.3 GB/s |
| 行列積 fp16 16384×16384 | 105.70 TFLOPS | 105.45 TFLOPS |
24GiBを埋めた状態でも、GPU内コピー帯域は601.0 → 599.9 GB/sとほぼ誤差の範囲にとどまりました。CPU↔GPU間の26.8 GB/sはPCIe Gen4 x16の理論値(約31.5 GB/s)に対して妥当な実効値であり、リンクもGen4 x16で正しく確立されています。増設された後半の16GB領域も、前半と同一の速度で正常に機能していることが確認できました。
検証結果② 量子化別の推論速度 — Q8_0が全層収容、生成速度はV100と同等水準
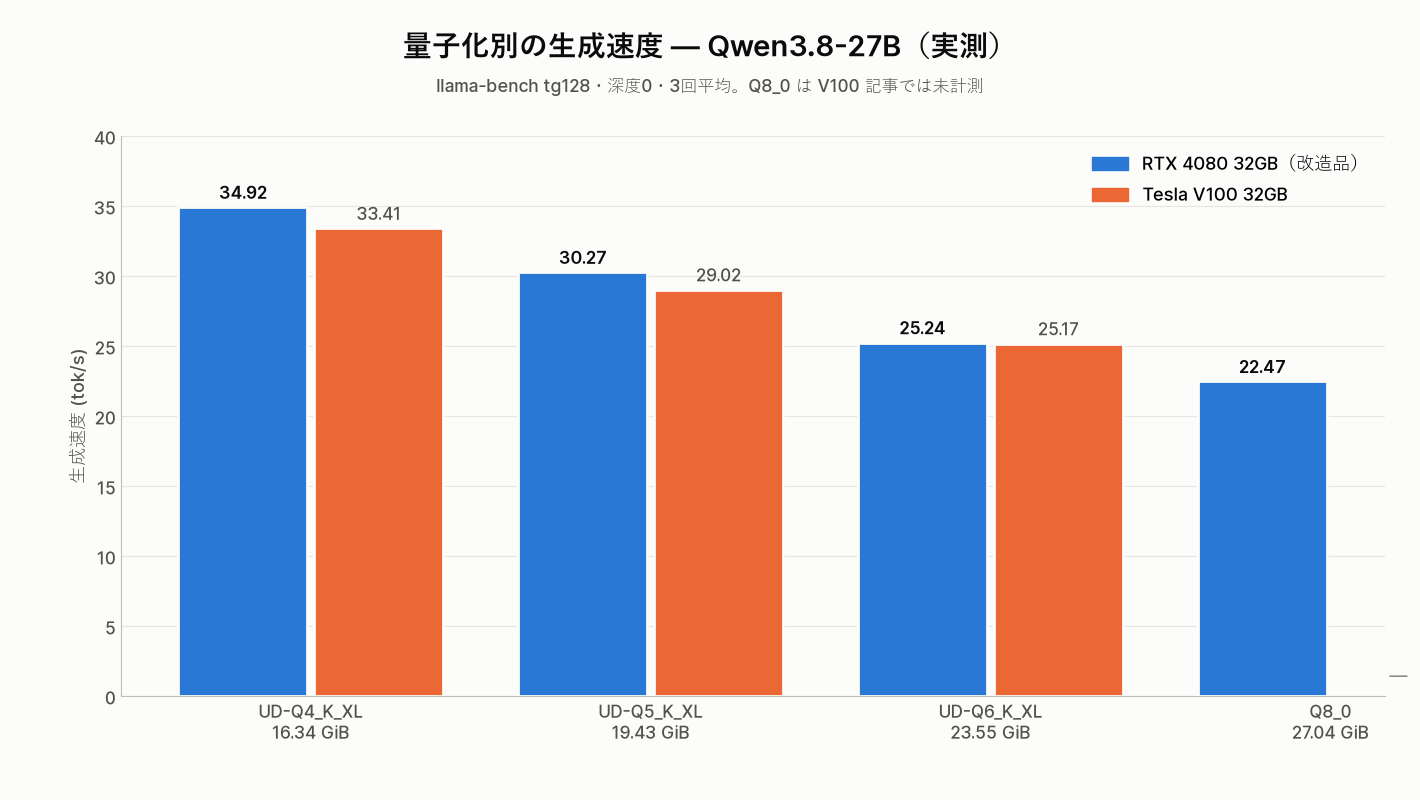
| 量子化 | サイズ | prefill | 生成 | prefill@32K | 生成@32K | ピークVRAM | V100の生成 |
|---|---|---|---|---|---|---|---|
| UD-Q4_K_XL | 16.34 GiB | 1,933.24 | 34.92 | 1,440.64 | 31.35 | 18,760 MiB | 33.41 |
| UD-Q5_K_XL | 19.43 GiB | 1,811.88 | 30.27 | 1,377.92 | 27.56 | 21,610 MiB | 29.02 |
| UD-Q6_K_XL | 23.55 GiB | 1,824.73 | 25.24 | 1,377.87 | 23.33 | 25,826 MiB | 25.17 |
| Q8_0 | 27.04 GiB | 1,934.74 | 22.47 | 1,440.67 | 20.94 | 29,012 MiB | — |
(単位はtok/s。ピークVRAMは深度32,768まで回したときの値。V100の値は前回記事の実測)
まず生成(デコード)速度です。UD-Q4_K_XLで34.92 tok/sを記録し、V100の33.41 tok/sに対して+4.5%の差にとどまりました。Q5で+4.3%、Q6では25.24 vs 25.17 tok/sとほぼ同一です。カタログ上のメモリ帯域ではV100が上回るものの、Ada世代のキャッシュ構造やFlashAttentionカーネルの効率化が帯域の差を相殺した形と考えられます。いずれにせよ、本カードは「生成速度を伸ばすため」の選択肢ではないことがはっきりと示されています。
一方でprefill(プロンプトの読み込み)は量子化サイズを問わず1,800〜1,900 tok/s台を維持し、V100(826〜882 tok/s)の2倍以上のスループットを出しています。アーキテクチャの世代差が素直に現れた結果であり、詳細は後述します。
そして最大の利点が、Q8_0(27.04 GiB)がコンテキスト32Kを含めて29,012 MiBに収まったことです。純正16GB版はもちろん、24GBのRTX 4090でも収まりきらないサイズです。Q4からQ8への引き上げで生成速度は34.92 → 22.47 tok/sに低下しますが、毎秒22トークン出ていれば対話用途でレスポンスの遅さを感じることはほとんどありません。
なお、後述のコンテキスト深度測定におけるQ4_K_XL(深度0)の実測値は34.98 tok/sでした。別プロセスでの計測による0.06 tok/sの微差があるため、以降の各節ではそれぞれの表に記載された数値を基準として比較します。
検証結果③ コンテキスト長 — ネイティブ262,144トークンを1枚で完走
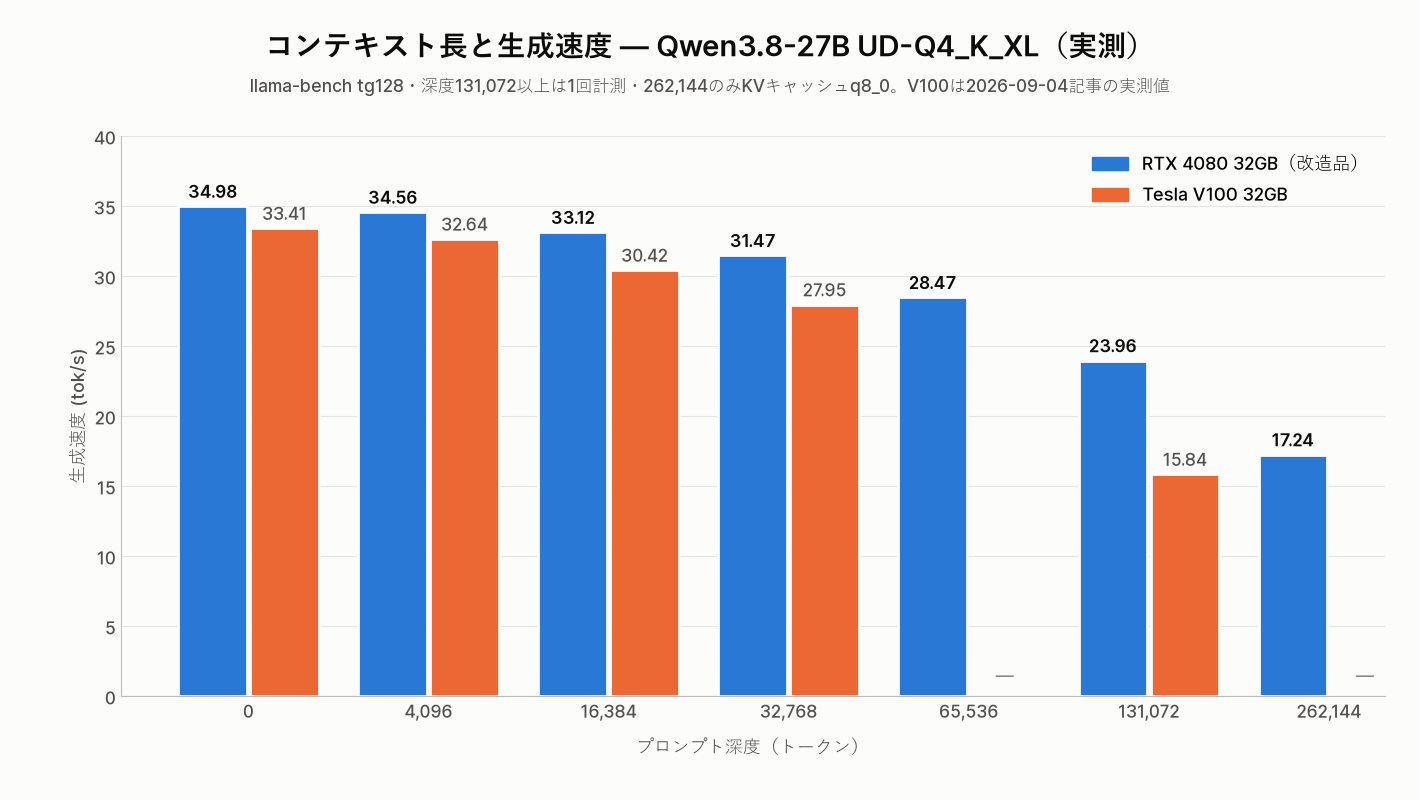
| プロンプト深度 | KVキャッシュ | prefill (tok/s) | 生成 (tok/s) | ピークVRAM | V100の生成 |
|---|---|---|---|---|---|
| 0 | f16 | 1,954.03 ± 42.23 | 34.98 ± 0.04 | 16,712 MiB | 33.41 |
| 4,096 | f16 | 1,855.82 ± 64.88 | 34.56 ± 0.08 | 16,952 MiB | 32.64 |
| 16,384 | f16 | 1,677.89 ± 42.49 | 33.12 ± 0.11 | 17,716 MiB | 30.42 |
| 32,768 | f16 | 1,428.27 ± 39.68 | 31.47 ± 0.09 | 18,760 MiB | 27.95 |
| 65,536 | f16 | 1,095.46 ± 14.42 | 28.47 ± 0.06 | 20,882 MiB | — |
| 131,072 | f16 | 767.51 | 23.96 | 24,996 MiB | 15.84 |
| 131,072 | q8_0 | 711.90 | 23.11 | 21,248 MiB | — |
| 262,144 | q8_0 | 434.03 | 17.24 | 26,240 MiB | — |
| 262,144 | f16 | 30分経過しても完了せず中断 | 32,332 MiB(飽和) | — | |
深度が浅いうちはV100との差は数%ですが、長大化するにつれて差が開いていきます。131,072トークン時点ではV100が15.84 tok/sまで落ち込んだのに対し、本カードは23.96 tok/s(約1.5倍)を維持。深度0からの低下幅もV100の-53%に対し、-32%にとどまりました。長い文脈を抱えたデコードではアテンション計算の比重が増加するため、Adaの演算性能が優位に働きます。
そして、Qwen3.8のネイティブ上限である262,144トークンへの挑戦です。32GBという容量の強みが最も発揮された結果であると同時に、運用上の落とし穴に直面した箇所でもありました。
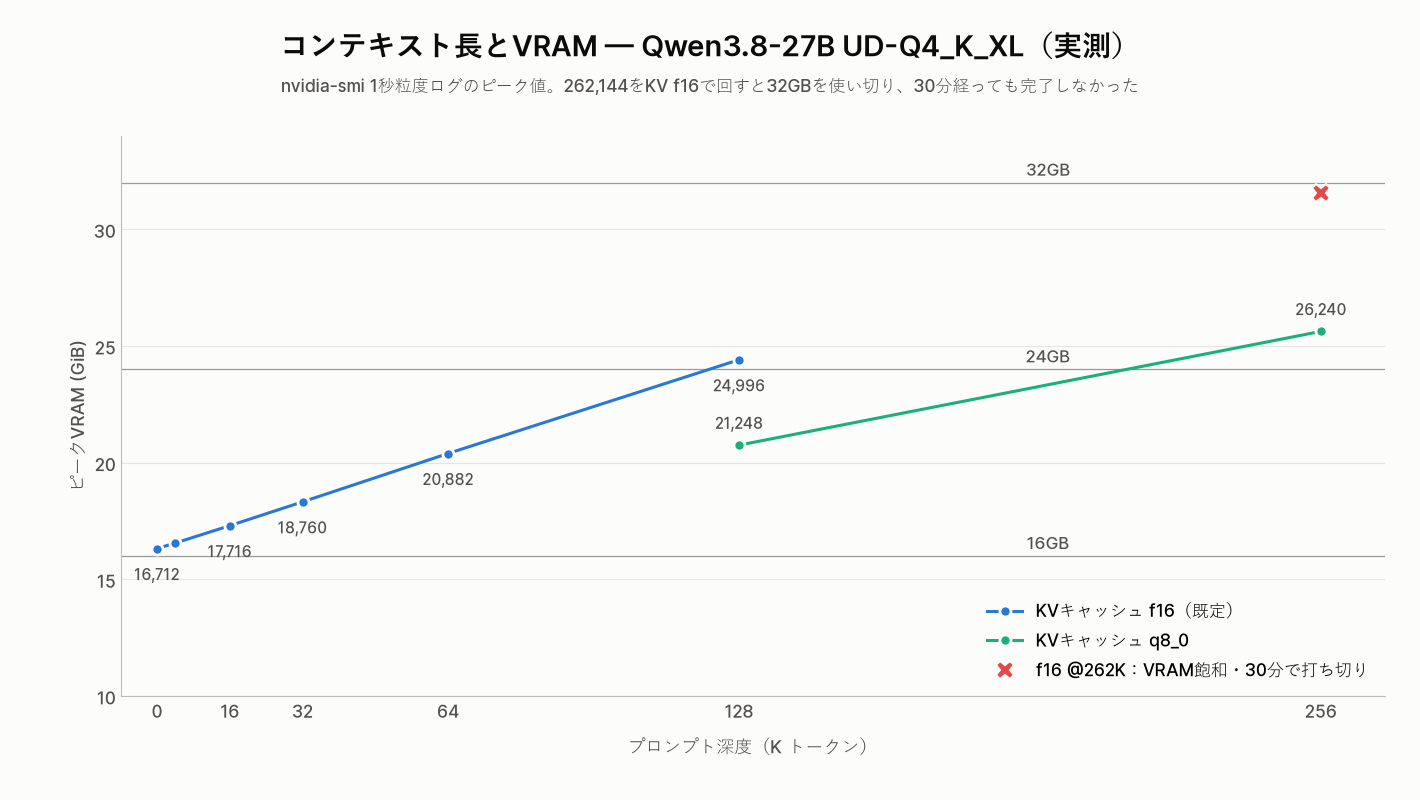
デフォルト(f16)のまま262Kを指定すると、エラーにならずサイレントに低速化する
標準のKVキャッシュ(f16)で深度262,144を実行したところ、VRAMが32,332 MiBに張り付いたまま処理が停止したかのような状態になりました。GPU使用率は100%を示しているものの、消費電力は通常時の320W付近から平均118.9Wまで急落していました。
Windowsのパフォーマンスカウンターを確認したところ、GPU共有メモリ(メインRAM)側へ約1.15GBがはみ出していました。Windows向けNVIDIAドライバは、VRAM枯渇時にCUDAの割り当てをシステムメモリへ逃がす設定が既定で有効になっています。そのためOut of Memoryで落ちる代わりに、PCIe経由の読み書きが発生して極端な低速化に陥っていました。30分待っても処理が終わらなかったため、測定を打ち切っています。
memory.used [MiB], utilization.gpu [%], power.draw [W]
32332 MiB, 100 %, 108.21 W    ← VRAM飽和、使用率100%、消費電力は3分の1に低下

InstanceName                        Shared Usage (bytes)
luid_0x00000000_0x00013206_phys_0 1154789376計算上、f16のKVキャッシュで262Kを保持すると32GBをわずかに超過します。不足分が1GB強であっても、メインメモリへのオフロードが発生した瞬間に実用性を失う点は押さえておく必要があります。「エラーで落ちていないから正常」ではなく、消費電力が不自然に急減した場合はVRAM溢れを疑うべきです。
KVキャッシュをq8_0に圧縮すると26GBで完走する
そこで -ctk q8_0 -ctv q8_0 を指定してKVキャッシュを8bit量子化して再実行したところ、262,144トークンがピーク26,240 MiBに収まり、生成速度17.24 tok/sで動作しました。ベンチマーク全体も6分25秒で完了しています。f16で30分経っても終わらなかった状態と比べれば雲泥の差です。
q8_0化に伴う性能影響も確認しました。131,072トークンで比較すると、生成速度はf16の23.96 tok/sに対してq8_0は23.11 tok/s(-3.5%)、prefillは767.51 → 711.90 tok/s(-7.2%)。一方でVRAM消費は3,748 MiB削減されています。V100ではKV量子化カーネルがCPUに落ちて実用になりませんでしたが、Ada Lovelaceでは完全にGPU上で動作します。長文コンテキストを扱うなら、KVキャッシュのq8_0指定が事実上の前提となります。
あわせてQ8_0モデルでの限界値も検証しました。KVキャッシュがf16のままでは深度65,536が31,114 MiB(19.63 tok/s)、KVをq8_0にすれば深度131,072が31,500 MiB(16.84 tok/s)で動作しました。Q8_0精度で128Kトークンを単一カードで扱えるのは32GBならではの芸当ですが、残存VRAMは約1.2GBと非常にタイトなため、実験的な領域と言えます。
検証結果④ prefill性能 — V100の2.4〜3.2倍。10万トークンの文書を85秒で読解
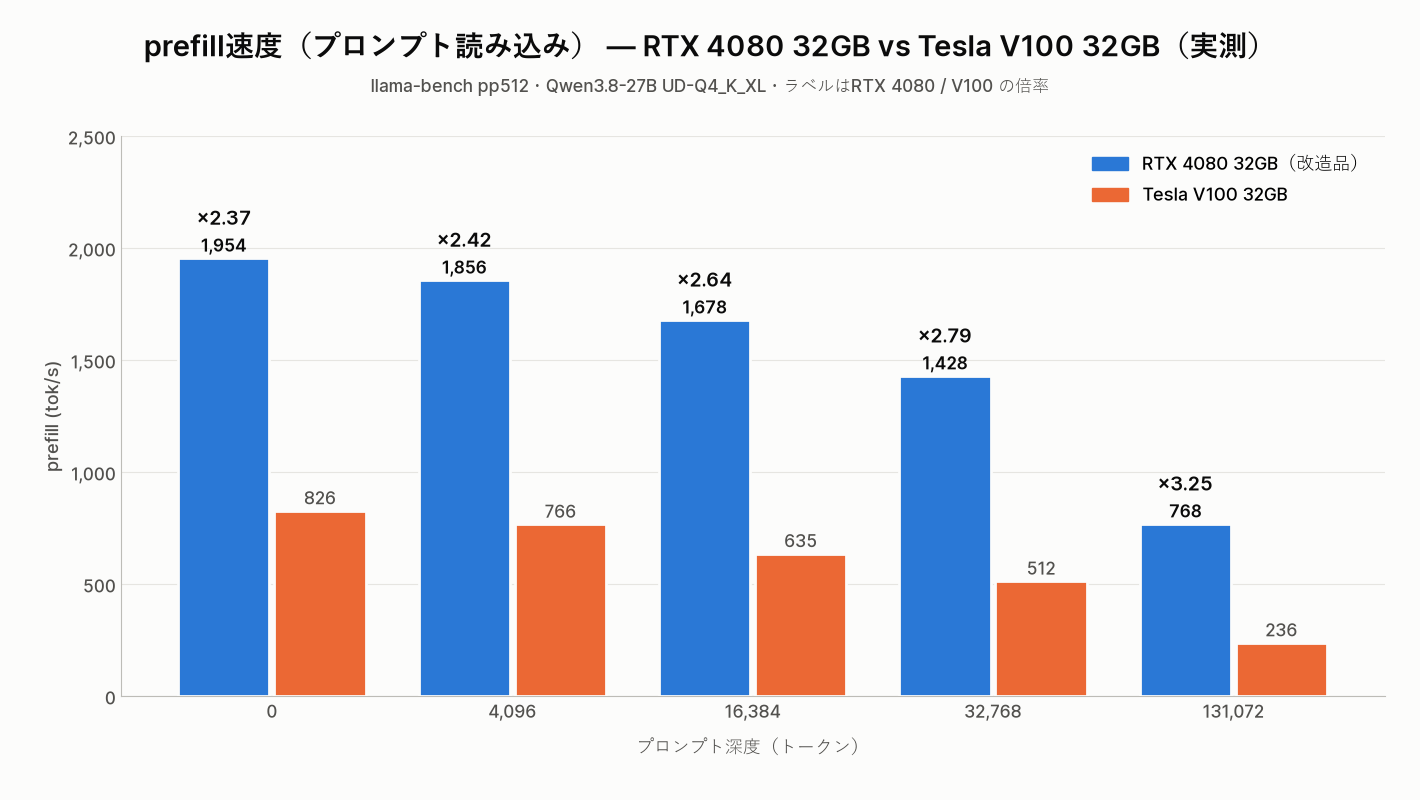
生成速度ではV100と拮抗していたのに対し、決定的な差がついたのがprefill(プロンプト処理)です。深度0で2.37倍、32,768で2.79倍、131,072では3.25倍に達し、コンテキストが深くなるほど世代差が拡大します。
prefill速度は、長大な文書を投入してから最初の1文字目が返ってくるまでの待ち時間(TTFT)に直結します。大量のドキュメントを丸ごと読み込ませるようなユースケースでは、生成速度以上に実用性を左右します。
実際の読解性能を確かめるため、約12万9千字(104,955トークン)の倉庫設備点検記録を作成し、その途中に「第7倉庫の予備電源装置のシリアル番号と次回点検日」という固有情報を1行だけ埋め込んで質問しました。他の倉庫にも類似の記録が多数並ぶ、ノイズの多い文書です。
質問: 第7倉庫の予備電源装置のシリアル番号と、次回点検日をそれぞれ答えてください。

第7倉庫の予備電源装置のシリアル番号と次回点検日は以下の通りです。

*   **シリアル番号:** RTX-KX-4080-32G
* **次回点検日:** 2027年3月14日| 項目 | 実測値 |
|---|---|
| プロンプト長 | 104,955トークン |
| 最初の1文字までの時間 | 84.8秒(prefill実効 1,237.6 tok/s) |
| 生成速度 | 25.35 tok/s |
| ピークVRAM | 25,064 MiB(-c 131072) |
| 回答精度 | シリアル番号・点検日ともに正解 |
約10.5万トークンの文書を走査し、回答を開始するまで84.8秒。待たされる印象を受けるかもしれませんが、V100では深度0の最高速(826 tok/s)で計算しても同じ文章の走査だけで2分以上を要し、コンテキストが深くなるにつれた減速を加味すると実運用では数分かかります。長文を読み込ませる用途において、本カードのprefill性能はV100と完全に一線を画しています。
検証結果⑤ 容量別の比較 — 16GB・24GB制限時の性能低下
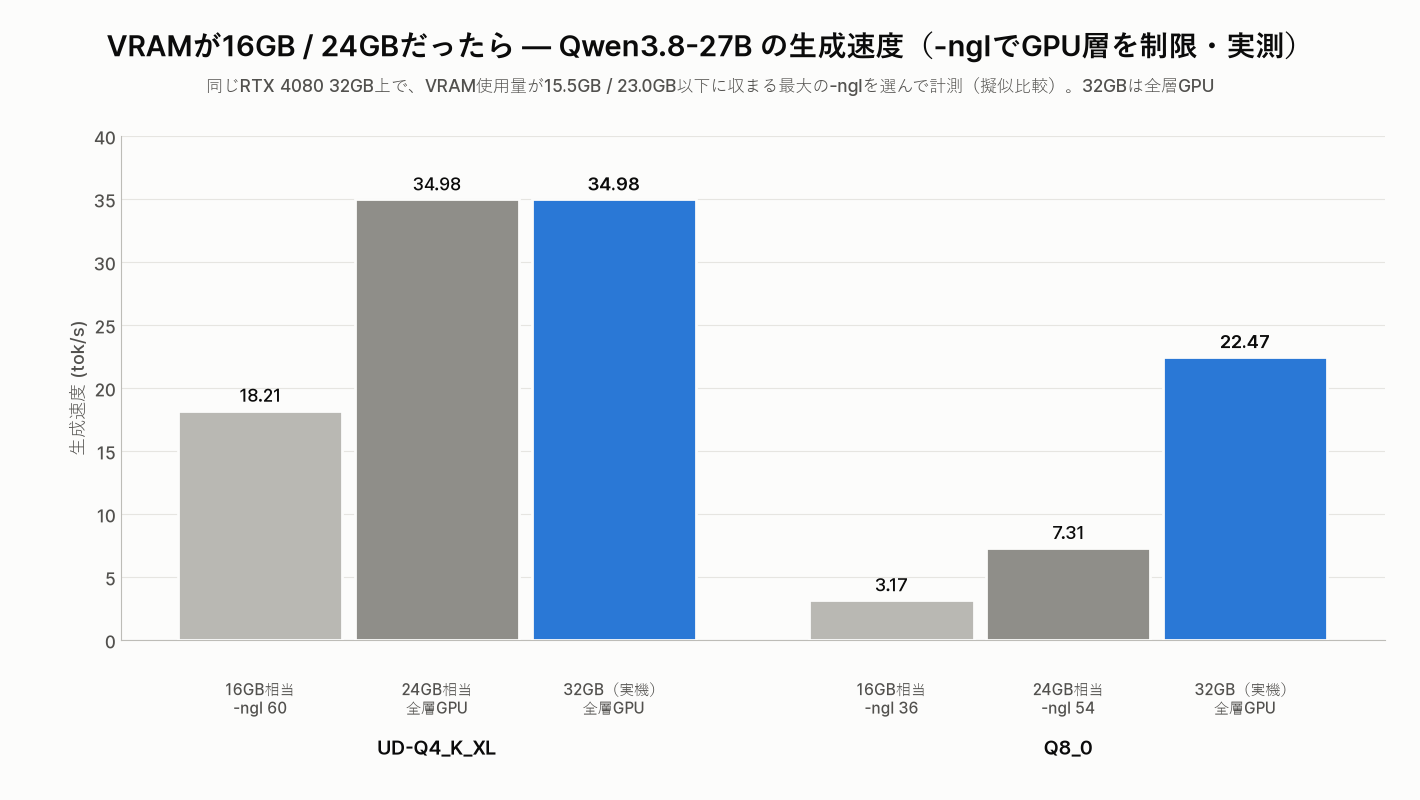
32GBの価値を測るため、「もしVRAMが16GBや24GBだった場合にどうなるか」を検証しました。別個体のカードを用意する代わりに、同一カード上で -ngl を絞り、ピークVRAMが15.5GB以下(16GB相当)および23.0GB以下(24GB相当)に収まる最大層数を割り当てて測定しています。GPUに載らない層はCPUとメインメモリで処理されるため、実機の16GB/24GBカードとは演算性能が異なりますが、容量制限時の挙動を再現できます。
| モデル | VRAM | GPUに載せた層 | ピークVRAM | prefill | 生成 |
|---|---|---|---|---|---|
| UD-Q4_K_XL | 16GB相当 | 60 / 65 | 15,428 MiB | 1,468.42 | 18.21 |
| 24GB相当 | 全層 | 16,712 MiB | 1,954.03 | 34.98 | |
| 32GB(実機) | 全層 | 16,712 MiB | 1,954.03 | 34.98 | |
| Q8_0 | 16GB相当 | 36 / 65 | 15,336 MiB | 500.63 | 3.17 |
| 24GB相当 | 54 / 65 | 22,314 MiB | 896.26 | 7.31 | |
| 32GB(実機) | 全層 | 29,012 MiB | 1,934.74 | 22.47 |
Q8_0モデルで極めて明確な差が現れました。全層GPU時の22.47 tok/sに対し、24GB相当では7.31 tok/s(約3分の1)、16GB相当では3.17 tok/s(約7分の1)へと急落します。わずか11層がCPU側に回っただけで3倍の速度低下が生じるのは、オフロードされた層を読み出すメインメモリ(DDR5-4800デュアルチャネル)の帯域幅がボトルネックとなるためです。
Q4_K_XLは24GB環境であれば全層が収まるため速度差はありません。しかし16GB環境ではQ4であっても全層ロードは不可能であり、5層溢れただけで34.98 → 18.21 tok/sとほぼ半減しました。27Bクラスのモデルを16GBで運用する場合、量子化をQ3以下まで削るか、この速度低下を受け入れる必要があります。
冒頭で「メモリ帯域が同じなら生成速度は変わらない」と述べましたが、実態は「VRAM内に全層が収まっている限り速度は変わらず、1層でも溢れてCPUオフロードが発生した瞬間に3〜7倍の速度差となって跳ね返る」ということです。32GBという容量の優位性は、この「オフロードの崖」を回避できる点にあります。
検証結果⑥ 125B MoE(Qwen3.8-Flash-Next)の動作 — メインメモリ併用で最大49.60 tok/s
Qwen3.8-Flash-Nextは、Qwen4アーキテクチャのプレビューとして公開されたモデルです。総パラメータ125Bに対し、1トークンあたりに活性化するのは6BというスパースMoE構成を持ち、これとは別に51Bのn-gram埋め込み層と4BのMTPヘッドを備えています。512個のエキスパートから1トークンごとに10個(+共有1個)を選択する構造です(ライセンスは qwen-community-1.0)。
llama.cppのアーキテクチャ名は qwen4exp で、b10998公式ビルドでそのまま認識されました。使用したのはUnslothの UD-Q2_K_XL(3分割・計73.45 GiB)。32GBのVRAMには収まりきらないため、64GBのシステムRAMへ一部をオフロードして実行します。
GGUF内部のテンソル構成を確認すると、この73.45 GiBの内訳は特殊な構造になっています。
| 中身 | サイズ | 性質 |
|---|---|---|
| エキスパート(48層分) | 42.92 GiB | 1トークンごとに一部のみ参照 |
n-gram埋め込み(per_layer_token_embd) | 26.82 GiB | テーブル参照のみ(IQ4_NL量子化) |
| それ以外(アテンション等) | 約3.7 GiB | 毎トークン全層で使用 |
毎トークン必ず通過する基本層は4GB弱にとどまり、全体の3分の1以上はテーブル参照で完結する埋め込み層です。そのためアテンション層などをGPUに常駐させ、エキスパート層を何層GPUに割り当てるかを --n-cpu-moe(CPU側に残すエキスパート層数)で調整しながら速度とVRAM消費を測定しました。
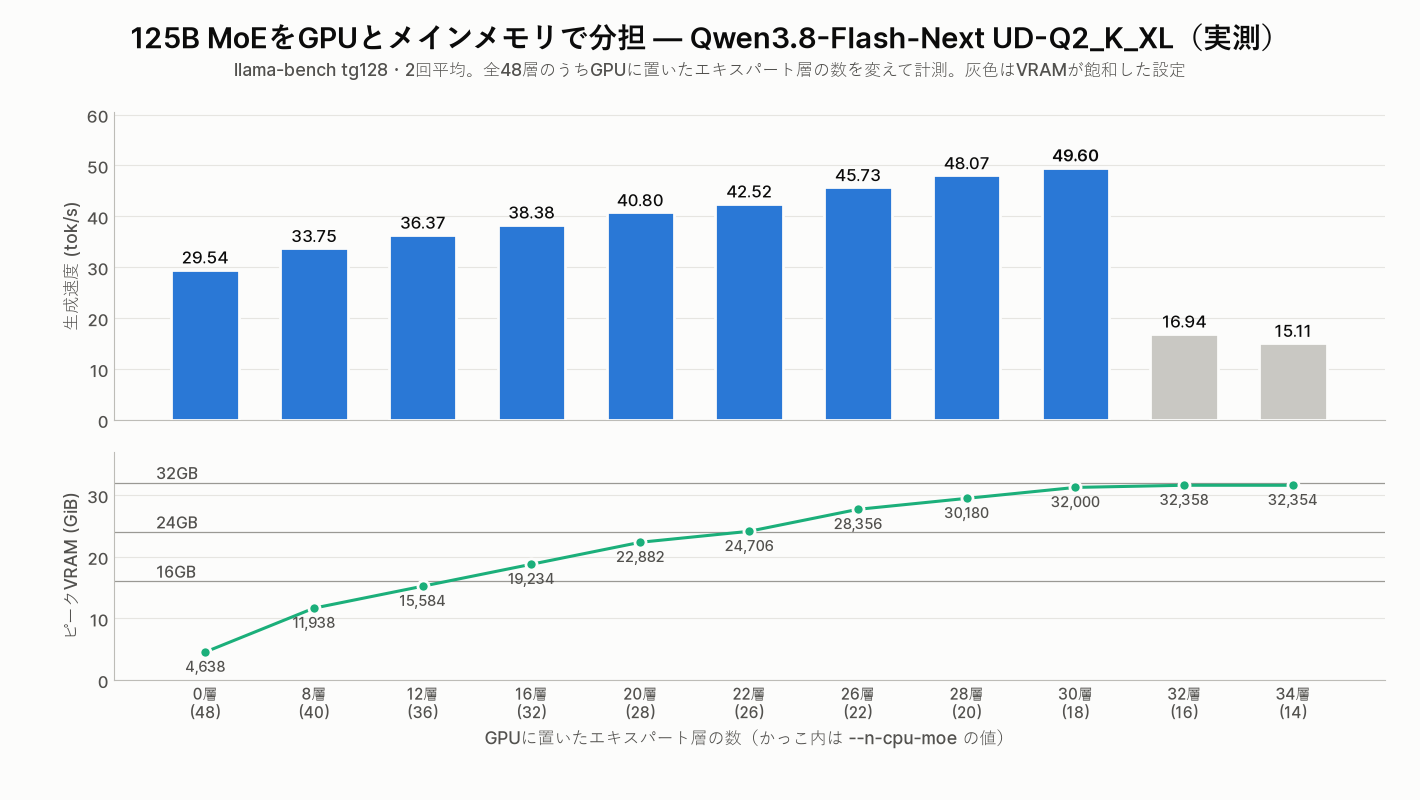
| GPUに置いたエキスパート層 | --n-cpu-moe | prefill (tok/s) | 生成 (tok/s) | ピークVRAM |
|---|---|---|---|---|
| 0 / 48 | 48 | 262.11 | 29.54 | 4,638 MiB |
| 8 / 48 | 40 | 301.28 | 33.75 | 11,938 MiB |
| 12 / 48 | 36 | 321.12 | 36.37 | 15,584 MiB |
| 16 / 48 | 32 | 340.12 | 38.38 | 19,234 MiB |
| 20 / 48 | 28 | 303.22 | 40.80 | 22,882 MiB |
| 22 / 48 | 26 | 387.95 | 42.52 | 24,706 MiB |
| 26 / 48 | 22 | 427.43 | 45.73 | 28,356 MiB |
| 28 / 48 | 20 | 436.58 | 48.07 | 30,180 MiB |
| 30 / 48 | 18 | 464.20 | 49.60 | 32,000 MiB |
| 32 / 48 | 16 | 101.10 | 16.94 | 32,358 MiB(飽和) |
| 34 / 48 | 14 | 75.81 | 15.11 | 32,354 MiB(飽和) |
注目すべきは、エキスパートを全層CPU側に置いた状態でも29.54 tok/sを記録した点です。125B規模のモデルでありながら、27B denseモデルのQ8_0(22.47 tok/s)を上回ります。トークンごとに活性化するパラメータが6B分に絞られているため、メインメモリからの読み出し量が少なくて済むためです。
GPUへの割り当てを増やすほど素直に高速化し、30層をGPUへ割り当てた --n-cpu-moe 18 で49.60 tok/sに達しました(VRAM 32,000 MiB)。
しかし、割り当てをさらに2層増やして --n-cpu-moe 16 にした瞬間、16.94 tok/sへと急落します。VRAMが32,358 MiBで張り付き、262K(f16)のときと同様にシステムメモリ退避が発生したためです。全層CPU時よりも低速化するため、実運用ではコンテキスト用の空き容量を見込み、--n-cpu-moe 20 あたりを上限とするのが安全です。
本結果から16GBおよび24GB環境の性能も概ね推測できます。16GBに収まるのは --n-cpu-moe 36(15,584 MiB・36.37 tok/s)、24GB相当(23GB以下)は --n-cpu-moe 28(22,882 MiB・40.80 tok/s)までです。32GB環境の上限(49.60 tok/s)と比較すると、16GB相当で約0.73倍、24GB相当で約0.82倍となります。denseモデルのような極端な崖ではなく、MoEではVRAM容量の拡大がなだらかな性能向上につながります。
深度32Kでの動作と実際の応答品質
--n-cpu-moe 20 で深度32,768を積んだ状態でも、生成速度は36.82 tok/s、4,096トークンのprefillは243.05 tok/sでした(ピークVRAM 31,374 MiB)。
llama-serverを立ち上げ、実際のプロンプトに対する応答も確認しました(-c 32768、thinking OFF、temperature 0)。
| タスク | 結果 | 生成速度 |
|---|---|---|
| 算数(リンゴとみかんの文章題) | 正解(答え: 9個、検算つき) | 40.71 tok/s |
| Pythonコード(llama-benchのJSONをMarkdown表に) | 仕様どおりの関数を出力。今回のベンチ結果に通して動作確認済み | 43.73 tok/s |
| 日本語(メリット・デメリットを3文ずつ箇条書き) | 内容は妥当だが箇条書きにせず、デメリットから書いた | 42.41 tok/s |
(算数の出力末尾)
したがって、太郎さんが買ったリンゴの個数は9個です。
(確認:リンゴ9個、みかん6個の場合、$120 \times 9 + 80 \times 6 = 1080 + 480 = 1560$ 円となり、条件を満たします。)

答え: 9個書式の指示を外した点について2bit量子化の影響かは切り分けられていませんが、Unslothが公開している指標でもUD-Q2_K_XLのBF16に対する平均KLダイバージェンスは0.2246と、Q4_K_XL(0.0469)より明確に劣化しています。それでも125Bクラスの応答が手元のPCから40 tok/s台で返ってくる実用性は特筆に値します。モデルロード時間は11.82秒、ロード時のシステムメモリ使用量はピーク54.59 GiBでした。
検証結果⑦ MiniMax H3で動画生成 — 32GBが速度に直結しなかった検証例
MiniMax H3は、映像と32kHzステレオ音声を同時に生成する33B規模のオムニモーダル動画生成モデルです(Hailuo 3.0とも呼ばれます)。ComfyUIが公式に対応しており、今回はComfy-Org配布のfp8版DiT(21.0GB)とint8版テキストエンコーダ(27.1GB、Qwen3-VL-32Bベース)を使用して検証しました。
ComfyUI同梱のテンプレートと同一のグラフをAPI経由で投入して計測しました。条件は1344×768・124フレーム(24fpsで5.17秒)・4ステップのturbo LoRAです。各構成につきウォームアップを行ってから、シードを変えて2本生成しました。
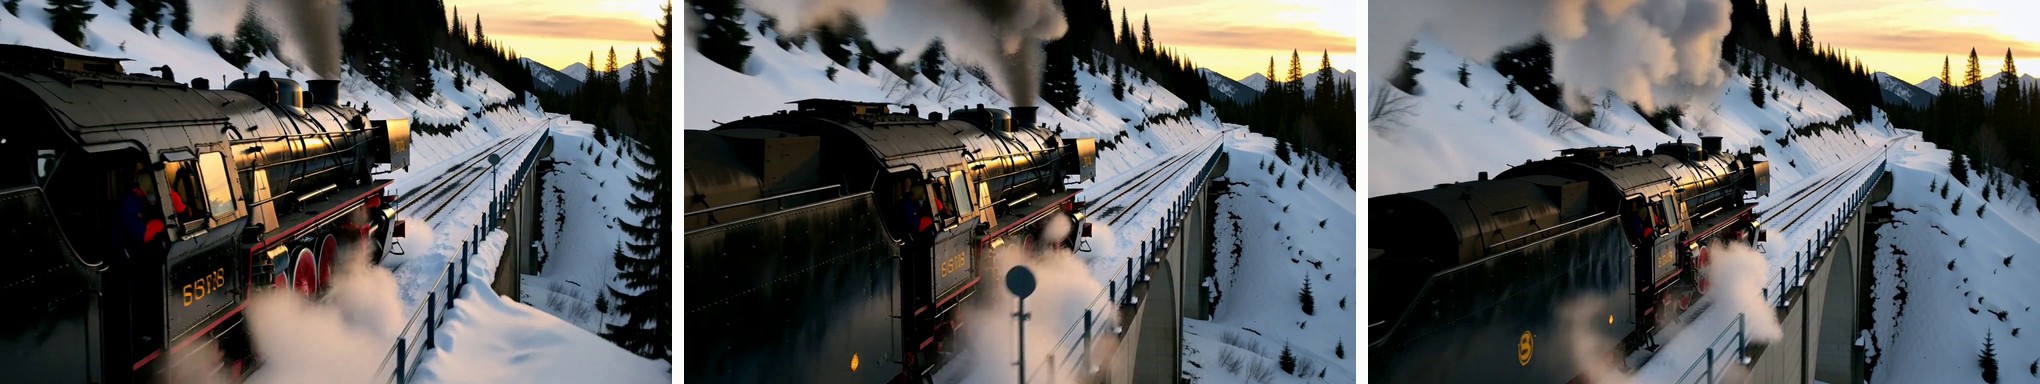
A steam locomotive crosses a snowy mountain bridge at dawn, the camera tracks alongside
the train as steam billows into the cold air. Audio: rhythmic chugging engine, a long whistle, wind.
雪山の鉄橋を渡る蒸気機関車で、汽笛や走行音も同期して生成されています。4ステップのturboで実用的な映像と音声が得られます。
速度の検証です。LLMと同様に「16GB / 24GBだったら」を確かめるため、ComfyUIの --reserve-vram オプションで8GB / 16GBを確保し、利用可能VRAMを制限した状態でも測定を行いました。
| VRAM | 起動オプション | 生成時間(シード1 / 2) | サンプリング 1ステップ | ピークVRAM |
|---|---|---|---|---|
| 32GB(そのまま) | — | 156.1秒 / 150.1秒 | 31.2秒 | 31,616 MiB |
| 24GB相当 | --reserve-vram 8 | 156.4秒 / 150.2秒 | 31.2秒 | 26,720 MiB |
| 16GB相当 | --reserve-vram 16 | 156.1秒 / 150.2秒 | 31.6〜31.8秒 | 18,432 MiB |
(生成時間はComfyUIにキューを投げてから動画ファイルが保存されるまで。テキストエンコード・サンプリング・VAEデコードを含む)
結果は、VRAM制限による速度差がほぼ生じないというものでした。16GB相当まで絞っても、1ステップあたりの所要時間はわずか1%程度しか伸びていません。ComfyUI 0.33は「ダイナミックVRAMローディング」によりモデルをステージングしており、VRAMに入り切らない重みは必要なタイミングでPCIe Gen4経由で流し込まれます。21GBの重みをPCIe Gen4(実測26.8 GB/s)で転送しても計算上は1秒未満であるのに対し、124フレーム分のアテンション計算に1ステップあたり約31秒を要するため、ボトルネックは容量ではなくGPU自体の演算能力にあります。
LLMでは「載るか載らないか」で数倍の差がついたのに対し、H3のturbo設定に関しては32GBの容量が直接の高速化理由にはなりませんでした。本カードで動画生成を高速化したい場合、容量ではなくステップ数や解像度の調整が必要となります。
なお、注意すべきはメインメモリの消費です。3構成ともシステム全体のメモリ使用量はピーク58〜60GBに達していました。int8テキストエンコーダ単体で27GBを占めるため、VRAMが32GBあってもメインメモリは64GBが下限となります。
turboを外した20ステップ(品質重視設定)でも測定しました。ウォームアップなしで2本続けて生成し、2本目が648.5秒(約10分49秒)、1本目はモデル読み込み込みで678.6秒でした。サンプリング時間は1ステップあたり31.2秒とturbo時と変わりません。ステップ数がそのまま処理時間に直結するため、プレビューはturbo、本番のみ20ステップという使い分けが現実的です。
消費電力と温度 — 20分連続でも速度は安定、メモリジャンクションは80℃前後
クラムシェル実装で懸念されるのが、ヒートシンクから離れた裏面メモリチップの放熱です。Q8_0(29GB級)で約3,000トークンの生成を10本連続(計20分間)で回し、GPUコア・ホットスポット・メモリジャンクション温度と消費電力を1秒刻みで記録しました。
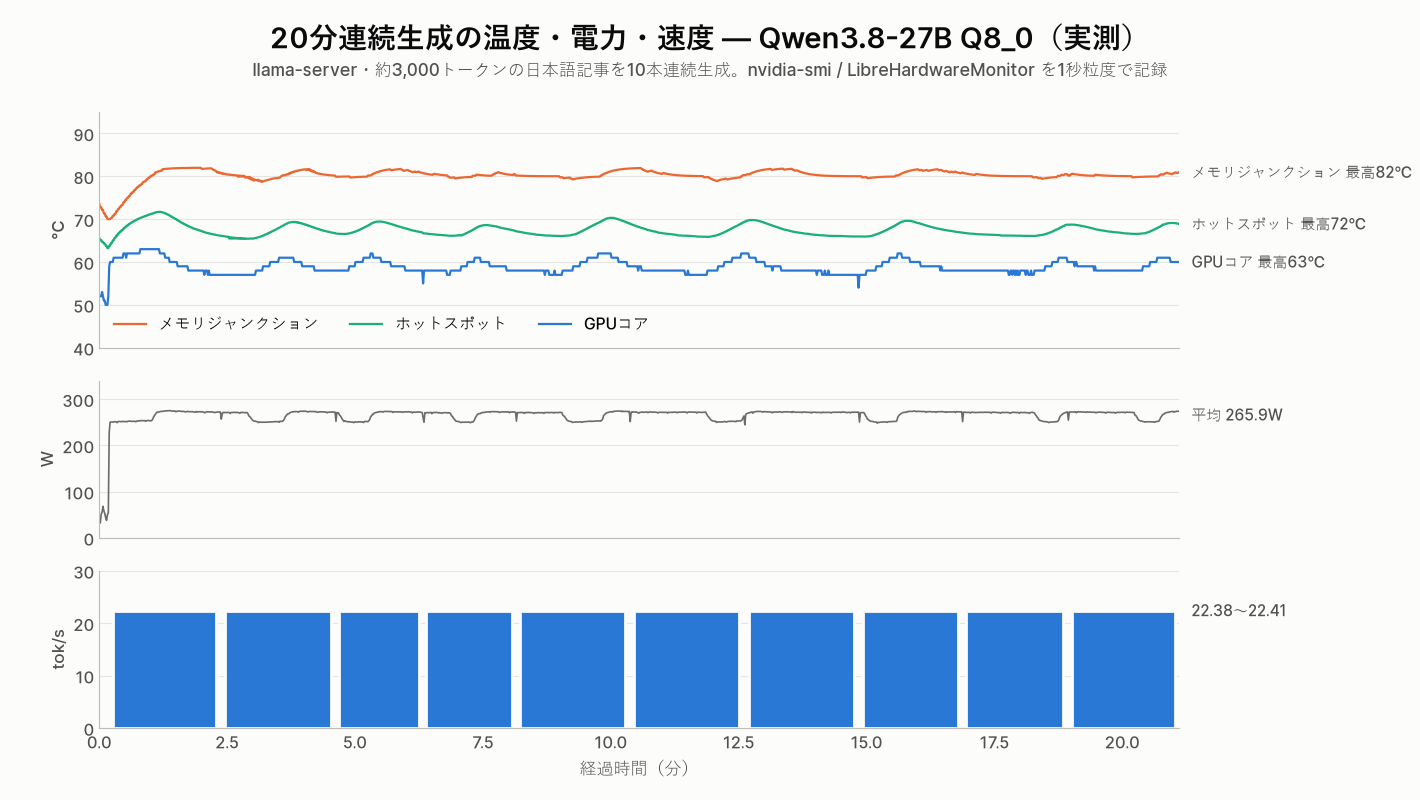
| 項目 | 最高 | 平均 |
|---|---|---|
| GPUコア温度 | 63℃ | 58.9℃ |
| ホットスポット温度 | 71.7℃ | 67.5℃ |
| メモリジャンクション温度 | 82.0℃ | 80.2℃ |
| 消費電力(生成中) | 275.4W | 265.9W |
| 生成速度(10本) | 22.38〜22.41 tok/s(生成28,092トークン) | |
| SMクロック(負荷中) | 2,775〜2,790MHz | |
生成速度は1本目から10本目まで22.38〜22.41 tok/sで完全に一定を維持しました。検証完了後にドライバのカウンタを確認したところ、SW/HWともにサーマルスロットリングは0マイクロ秒でした。電力上限(320W)による制限は入るものの、温度による性能低下は一度も発生していません。
> nvidia-smi -q -d PERFORMANCE
    Clocks Event Reasons Counters
        SW Power Capping                  : 170115776 us
        Sync Boost                        : 0 us
        SW Thermal Slowdown               : 0 us
        HW Thermal Slowdown               : 0 us
HW Power Braking : 0 usコア温度は60℃前後と余裕があるのに対し、メモリジャンクション温度が80℃前後に張り付くのが本カードの特徴です。GDDR6Xの許容範囲内には収まっているものの、コア温度の低さだけで冷却に余裕があると判断するのは避けたほうが安全です。なお、この温度を維持するためにファン回転数は30〜93%の間で激しく推移しており、静音性の高いカードではありません。
消費電力は20分連続の平均で265.9W。prefill時や262K(KV q8_0)などの高負荷処理では上限の320Wに張り付き、ピーク321.08Wを記録しました。V100のピーク269.2Wより約50W高いため、電源容量には余裕を持たせる必要があります。
改造品特有の挙動と注意点 — BAR1 16GB、メモリ溢れ、ファン
BAR1が16GBのまま。モデルロードは mmap より --load-mode none が高速
前述の通り、本カードはVRAMが32GBと認識されている一方で、BAR1(CPUから直接VRAMを参照するアパーチャ)は16,384 MiBのままです。モデルの読み込み方式によって差が出るかを検証するため、llama.cppの --load-mode を変えてサーバーが応答可能になるまでの時間を3回ずつ測定しました(ファイルはOSキャッシュ上の状態)。
| モデル | mmap(既定) | none | dio(DirectIO) |
|---|---|---|---|
| UD-Q4_K_XL(16.34 GiB) | 6.04 / 5.98 / 6.00秒 | 2.77 / 2.85 / 2.78秒 | 2.84 / 3.00 / 2.87秒 |
| Q8_0(27.04 GiB) | 9.49 / 9.32 / 9.24秒 | 4.06 / 4.01 / 4.09秒 | 4.13 / 4.05 / 4.13秒 |
mmapは none に比べて2倍以上の時間を要しました。ただしmmapはページフォルトを伴うため純正カードでも遅延要因になりやすく、この差がBAR1 16GB制限に起因するかどうかまでは切り分けられていません。いずれにしても全層をVRAMに展開する前提なら --load-mode none を指定するのが確実です。なお、旧バージョンの --no-mmap はb10998で廃止されており、指定すると起動エラーとなります。
error: invalid argument: --no-mmapVRAMが溢れると、エラーを出さずに極端に遅くなる
262K(f16)の検証で触れた通り、Windowsドライバは規定でVRAM不足分をシステムメモリへ逃がします。32GBあると上限近くまで詰め込みがちですが、空き容量が1GBを切るような設定は避けるのが賢明です。クラッシュさせてOOMを検知したい場合は、NVIDIAコントロールパネルの「CUDA – システムメモリフォールバックポリシー」で変更可能です(今回の測定はすべて規定値)。
ファンの動作音
本個体はシングルファン仕様で、ファン制御にもクセがありました。自作サービスでメモリジャンクション温度を監視しながら制御を行いましたが、それでも高負荷時にはファンが30〜93%の間で変動します。デスクサイドで静かに常用する用途には向きません。
ドライバは通常のGeForce用で動作
改造ハードウェアではあるものの、NVIDIA公式ドライバ(616.56)を導入するだけで32GBとして正常認識されました。CUDA 13.4のllama.cpp、cu130のPyTorch、Vulkanのmemtest_vulkanに至るまで、特殊なパッチ等は一切不要でした。
Tesla V100 32GBとの比較 — 同じ32GBでも「読む速さ」と機能性が異なる
| 項目(Qwen3.8-27B UD-Q4_K_XL) | RTX 4080 32GB改造品 | Tesla V100 32GB |
|---|---|---|
| 生成(深度0) | 34.98 tok/s | 33.41 tok/s |
| 生成(深度131,072) | 23.96 tok/s | 15.84 tok/s |
| prefill(深度0) | 1,954.03 tok/s | 826.03 tok/s |
| prefill(深度131,072) | 767.51 tok/s | 236.50 tok/s |
| ピークVRAM(深度131,072) | 24,996 MiB | 25,264 MiB |
| KVキャッシュ q8_0 | GPUで動作 | CPUに落ちて実質停止 |
| 262,144トークン | KV q8_0で17.24 tok/s | 未計測 |
| ピーク電力 | 321.08 W | 269.2 W |
| llama.cpp | 公式バイナリでそのまま動作 | sm_70向けに自前ビルドが必要 |
| 映像出力 | あり | なし |
| 保証 | なし(改造品) | なし(中古サーバー放出品) |
短い対話のみであれば、生成速度は同水準のためV100でも実用上の差はほとんどありません。決定的な差がつくのは、長大なプロンプトを読み込ませる場面と、KVキャッシュ量子化などの最新機能を利用する場面です。V100ではCPUフォールバックにより実質使用不可だった機能が、本カードでは完全にGPU上で完結します。
価格面では、海外報道によると中国の中古市場で1万元(約1,480ドル)前後から流通しています。V100 32GBよりは高価ですが、同じ32GB容量を持つRTX 5090の米国希望小売価格(1,999ドル)を下回る位置付けです。無保証の改造品というリスクを許容し、上記表の諸機能に投資価値を見出せるかが判断の分かれ目となります。
向いている人・注意点
向いている人
- 27B〜32BクラスのモデルをQ6〜Q8の高精度で全層GPUに載せたい人(24GB環境ではQ8_0が約3分の1の速度に低下)
- 10万トークン規模の文書やコードベースを丸ごと読み込ませたい人(prefillがV100比で2.4〜3.2倍、262K長文も1枚で完走)
- 100B規模のMoEモデルを、メインメモリ併用で手元で動かしたい人
注意点
- 生成速度は純正16GB版と同等:16GBに収まるモデルしか扱わない場合、速度面の向上はありません。
- 動画生成(MiniMax H3のturbo設定)では、16GB相当に絞っても速度はほぼ変わりませんでした。動画生成の高速化目的での選択はおすすめできません。
- メーカー保証はありません。ファンの動作音も大きめです。
- VRAMが溢れるとエラーにならずサイレントに低速化します。消費電力の急減があればメモリ溢れを疑う必要があります。
- 100B級MoEや動画生成を行う場合、メインメモリは64GBでも上限に近くなります。
まとめ
RTX 4080 32GB改造品は、「既存の処理を速くするカード」ではなく、「これまで載らなかったワークロードを載せるカード」でした。
- 生成速度はQ4_K_XLで34.98 tok/s。帯域据え置きの仕様通り、V100 32GB(33.41 tok/s)とほぼ同等
- Q8_0(27.04 GiB)が全層GPUに収まり22.47 tok/s。24GB相当(7.31 tok/s)や16GB相当(3.17 tok/s)に対して明確な優位性
- 262,144トークンがKV q8_0により26,240 MiBに収まり17.24 tok/s。デフォルトのf16ではメモリ溢れにより30分経っても完了せず
- prefill速度はV100比で2.37〜3.25倍。10.5万トークンの資料を84.8秒で読み込んで正確に回答
- 125B MoE(Qwen3.8-Flash-Next UD-Q2_K_XL)はメインメモリ併用で最大49.60 tok/s。限界を超えると16.94 tok/sに急落
- MiniMax H3動画生成(1344×768・5秒・turbo)は約150秒。演算能力が律速となるため16GB相当に絞っても速度は変わらず
- 全域テストはエラー0、24GiB確保後も約600 GB/sの帯域を維持。20分連続高負荷でもサーマルスロットリングなし
16GB版で「あと数GB足りない」と感じていたユーザーには、まさにピンポイントで刺さるカードです。逆に、扱いたいモデルが16GB内に収まっているなら、同一の処理速度に対して余計なコストを払うことになります。32GBという大容量の価値は、その「収まりきらない境界線」を超えた瞬間に3倍、7倍という圧倒的な速度差として現れます。
検証ノート(再現用)
本文の数値はすべて以下のコマンドの出力から取っています。計測は2026年9月16日、同一マシン・同一ビルドで実施しました。
# llama.cpp(公式ビルドを解凍するだけ)
llama-b10998-bin-win-cuda-13.4-x64.zip + cudart-llama-bin-win-cuda-13.4-x64.zip

# モデル取得
hf download unsloth/Qwen3.8-27B-GGUF Qwen3.8-27B-UD-Q4_K_XL.gguf Qwen3.8-27B-UD-Q5_K_XL.gguf ^
  Qwen3.8-27B-UD-Q6_K_XL.gguf Qwen3.8-27B-Q8_0.gguf --local-dir models
hf download unsloth/Qwen3.8-Flash-Next-GGUF --include "UD-Q2_K_XL/*" --local-dir models\flashnext

# 量子化スイープ
llama-bench -m models\Qwen3.8-27B-<量子化>.gguf -ngl 99 -p 512 -n 128 -d 0,32768 -r 3

# 深度スイープ(深度ごとに別プロセス。131,072以上は -r 1)
llama-bench -m models\Qwen3.8-27B-UD-Q4_K_XL.gguf -ngl 99 -p 512 -n 128 -d 65536 -r 3
llama-bench -m models\Qwen3.8-27B-UD-Q4_K_XL.gguf -ngl 99 -p 512 -n 128 -d 262144 -r 1 -ctk q8_0 -ctv q8_0

# 16GB / 24GB 相当(-ngl を絞る)
llama-bench -m models\Qwen3.8-27B-Q8_0.gguf -ngl 54 -p 512 -n 128 -r 2

# Qwen3.8-Flash-Next(エキスパートの一部をCPUへ)
llama-bench -m models\flashnext\UD-Q2_K_XL\Qwen3.8-Flash-Next-UD-Q2_K_XL-00001-of-00003.gguf ^
  -ngl 99 --n-cpu-moe 20 -p 512 -n 128 -r 2

# ロード時間
llama-server -m models\Qwen3.8-27B-Q8_0.gguf -ngl 99 -c 4096 --load-mode none

# MiniMax H3(ComfyUI 0.33.0 を起動した状態で、テンプレートと同じグラフをAPIで投入)
python main.py --fast fp16_accumulation fp8_matrix_mult [--reserve-vram 8 | 16]

# VRAM・電力・温度(1秒粒度)
nvidia-smi --query-gpu=memory.used,utilization.gpu,power.draw,temperature.gpu,clocks.sm,clocks.mem,pcie.link.gen.gpucurrent --format=csv,noheader,nounits -l 1
llama-bench は3回計測(深度131,072以上とQ8_0の深い深度は1回、-ngl・--n-cpu-moe のスイープは2回)。VRAM・電力・温度は1秒粒度ログのピーク値、メモリジャンクション温度はLibreHardwareMonitorのセンサー値です。
それでは、また。
コメントを残す