
こんにちは、七宮さん(@shichinomiya_s)です。
前回はQwen 3.6をM1 Max 64GBのMLXで実測しましたが、今回は同じQwen 3.6をNVIDIA Tesla V100 32GBで動かしてみました。V100は2017年登場のデータセンターGPUで、当時100万円超だったフラッグシップが、いまAliExpressで13万円台まで落ちてきています。「32GB VRAMのCUDA GPUが13万円」と聞くと、ローカルLLM用に俄然気になりますよね。
モデルは前回と同じQwen 3.6のdense 27BとMoE 35B-A3B、ランタイムはllama.cppです。速度・VRAM・電力に加えて、今回は成果物の中身(算数の解答・要約文・生成されたToDoアプリの実動)まで細かく見ていきます。
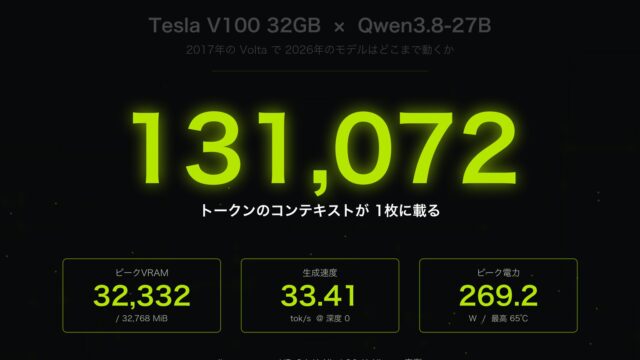
結論から言うと、速度は文句なしでした。MoE 35B-A3B(4bit)が98.8 tok/sで、M1 Max(61.2 tok/s)の約1.6倍。dense 27Bでも32.9 tok/sと実用十分です。ただし手放しでは勧められません。配布されているllama.cppのプリビルドバイナリがもうV100(Volta世代)を切り捨てており、自分でビルドしないと1トークンも生成できないという、2026年ならではの罠を踏みました。速度・品質・コスパ・罠、すべて実測と実物で正直にレビューします。
Tesla V100 とは — なぜ今さら2017年のGPUなのか
Tesla V100はNVIDIAのVolta世代データセンターGPUで、2017年に登場しました。かつてスパコンやクラウドのAI学習を支えた「元・最強」で、初代Tensorコアを搭載した記念碑的な世代でもあります。スペックは今見ても悪くありません。
| 項目 | Tesla V100 32GB |
|---|---|
| アーキテクチャ | Volta(compute capability sm_70)・2017年 |
| CUDAコア / Tensorコア | 5,120 / 640(初代Tensorコア) |
| VRAM | 32GB HBM2・帯域約900GB/s |
| TDP | 250W(PCIe版)/ 300W(SXM2版) |
| 映像出力 | なし(計算専用。画面は出せない) |
| 中古価格 | 13万円台〜(AliExpress、2026年7月時点) |
注目はHBM2の帯域約900GB/sです。LLMの生成速度は演算力よりメモリ帯域で決まる(1トークン生成するたびにモデル全体を読む)ので、ここが太いGPUは古くても速い。参考までにM1 Maxは400GB/s、RTX 4090は約1,000GB/sです。つまり帯域だけ見れば、V100は2022年のフラッグシップに肉薄しています。
そして何より、データセンターのリプレースで放出された中古が大量に市場へ流れ、「VRAM 32GBのCUDA GPU」をこの値段で買える選択肢は他にほぼない状況です。RTX 4090(24GB)より広いVRAMが半額以下、と考えると夢があります。ただし2017年のGPUには2017年なりの事情もあります。それが後述の「Volta切り捨て問題」です。まずは数字から見ていきます。
検証環境
| 項目 | 内容 |
|---|---|
| GPU | Tesla V100-SXM2-32GB(Volta, compute capability 7.0) |
| CPU | Xeon Platinum 8260(96スレッド) |
| ドライバ / CUDA | 580.159.03 / CUDA 12.9 |
| ランタイム | llama.cpp(ソースからsm_70向けに自前ビルド) |
| モデル | unsloth の GGUF 版 Qwen 3.6 |
| 計測方法 | 各タスク2回ウォーム実行→最終run採用 / temperature=0 / context 16384 |
テストしたモデルは以下の3つです。
| モデル | 量子化 | 種別 | DLサイズ |
|---|---|---|---|
| Qwen3.6-27B-GGUF:Q4_K_M | 4bit | dense 27B | 約21GB |
| Qwen3.6-27B-GGUF:Q8_0 | 8bit | dense 27B | 約28GB |
| Qwen3.6-35B-A3B-GGUF:UD-Q4_K_M | 4bit | MoE 35B / 活性3B | 約22GB |
タスクは前回のM1 Max検証と同じ日本語要約・コード生成・推論(算数)・長文生成の4種。速度計測はthinking ON(Qwen 3.6の既定)、成果物の品質評価は完全な出力を得るためthinking OFF(enable_thinking:false + /no_think)で別途実施しています。
なお、今回計測した個体はSXM2版(サーバー専用フォームファクタ)ですが、中古市場に出回っているPCIe版とGPUチップは同じです。PCIe版はブーストクロックがやや低い(1380MHz vs 1530MHz)ため、手元では今回の数字から1割弱遅くなる可能性がある点は先に書いておきます。
検証結果① 生成速度 — MoE 35B-A3Bが98.8 tok/s、dense 27Bの約3倍速
まず生成速度(decode tok/s)です。4タスクすべてで傾向は完全に一致しました。

| タスク | 27B Q4_K_M (dense) | 27B Q8_0 (dense) | 35B-A3B Q4 (MoE) |
|---|---|---|---|
| 日本語要約 | 33.04 | 23.27 | 99.02 |
| コード生成 | 32.76 | 23.38 | 98.60 |
| 推論(算数) | 33.03 | 23.51 | 99.14 |
| 長文生成 | 32.88 | 23.26 | 98.54 |
| 平均 decode | 32.9 tok/s | 23.4 tok/s | 98.8 tok/s |
| 平均 prefill | 206 tok/s | 219 tok/s | 352 tok/s |
MoE 35B-A3Bが98.8 tok/sと爆速です。画面上は読むのが追いつかないどころか、文章がスクロールで流れていくレベル。dense 27B(Q4)の約3.0倍速で、前回M1 Maxで確認した「MoEはdenseより圧倒的に速い」という傾向が、CUDAプラットフォームでもきれいに再現されました。理屈も同じで、35B-A3Bはトークンごとに約3Bしか活性化しないため、毎回27B全部を読むdenseより計算もメモリ読み出しも軽いからです。
dense 27BもQ4_K_Mで32.9 tok/sと、チャット用途には十分な実用速度。一方Q8_0は23.4 tok/sとQ4より約29%遅い。8bitは重みの読み出し量がほぼ倍になるので、メモリ帯域律速のLLM推論では素直に遅くなります。プロンプト処理(prefill)もMoEが最速の352 tok/sで、長いプロンプトを投げたときの待ち時間も短めでした。
検証結果② VRAM・温度・電力 — Q8_0は32GBギリギリ、MoEは省電力
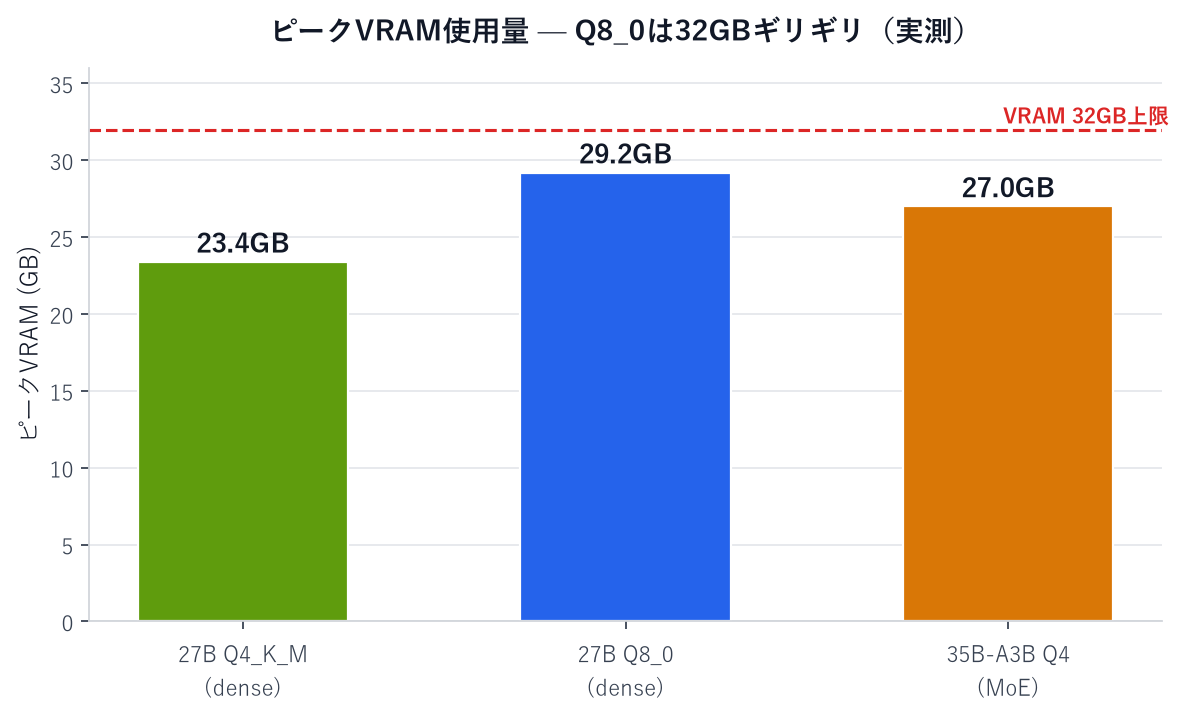
| 指標 | 27B Q4_K_M | 27B Q8_0 | 35B-A3B MoE Q4 |
|---|---|---|---|
| ピークVRAM | 23.4GB | 29.2GB | 27.0GB |
| ピーク電力 | 308.6W | 292.4W | 206.2W |
| ピーク温度 | 78°C | 72°C | 74°C |
| ロード時間(ウォーム) | 9.0s | 11.0s | 11.0s |
ポイントは3つあります。
① Q8_0は29.2GBで32GBにギリギリ収まる(残り約2GB)。context 16384では動きましたが、長コンテキストを取る余裕はありません。ユニファイドメモリ64GBのM1 Maxとの決定的な差がここです。逆にQ4_K_Mなら23.4GBで、コンテキスト拡張や複数モデル同時実行の余地があります。
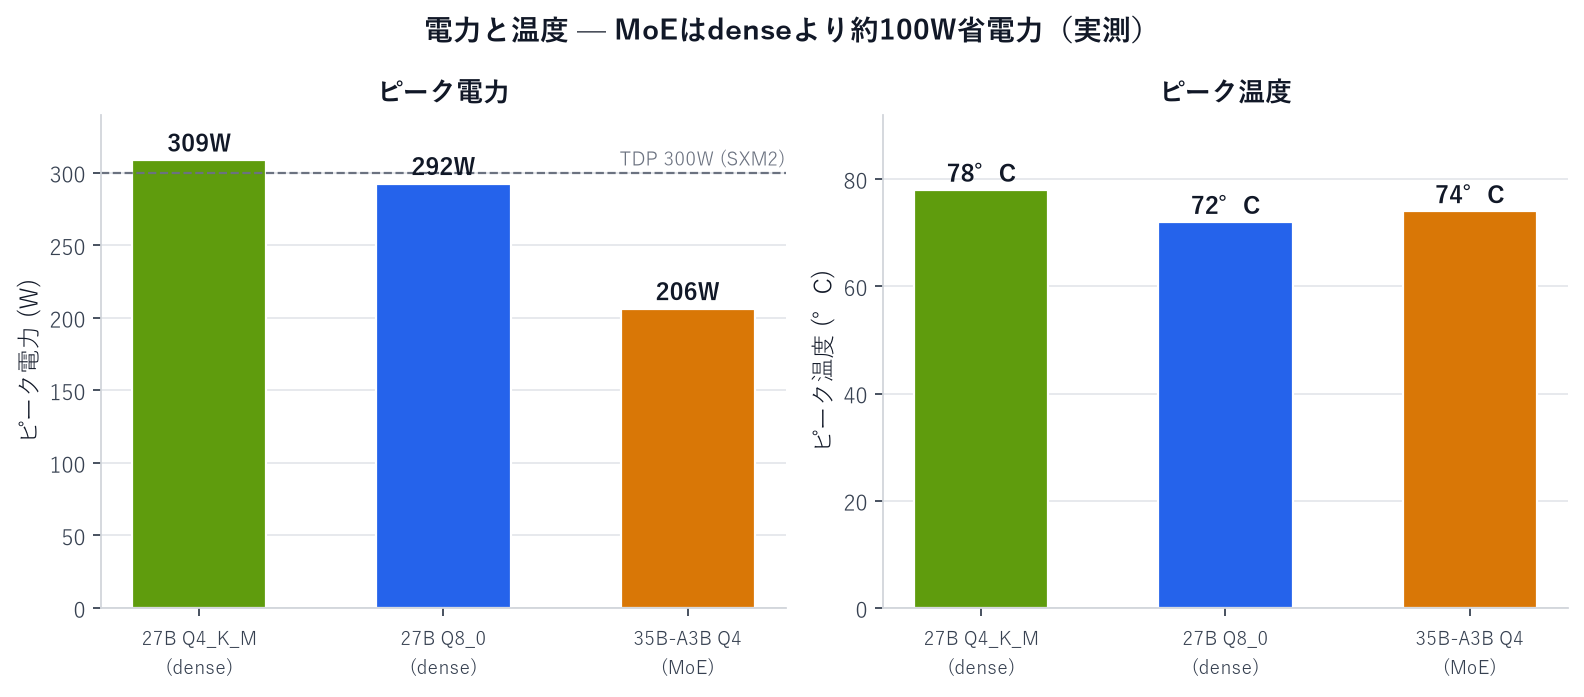
② MoEは電力が206Wと、denseより約100W低い。活性パラメータが少なくメモリ帯域待ちの時間が長いためで、denseは演算がフル回転して300W超まで上がります。「一番速いモデルが一番省電力」という嬉しい逆転で、電気代・発熱の観点でもMoEが優等生でした。
③ 温度は72〜78°C。ただしこれはサーバーの強制空冷が効いている環境での数字です。V100はもともとファンレス設計(筐体のエアフローで冷やす前提)なので、普通のPCで使うならファン付きモデルの選択が事実上必須です。ここは後述のコスパ分析で触れます。
検証結果③ 品質 — 実際の出力を全部見せます
速度が出ても中身がダメなら意味がないので、thinking OFFで完全な出力を取得して中身を確認しました。結論の一覧がこちらです。
| 評価軸 | 27B Q4 | 27B Q8 | MoE Q4 |
|---|---|---|---|
| 推論(算数の文章題) | ✅ 正解・検算付 | ✅ 正解・検算付 | ✅ 正解・検算付 |
| コード(ToDoアプリ) | ✅ 全機能動作 | ✅ 全機能動作 | ✅ 全機能動作・UI最良 |
| 日本語要約 | 149字・忠実 | 153字・忠実 | 175字・網羅的 |
| 長文(1200〜1500字) | 構成◎・具体例あり | 構成が最も明快 | 読みやすい |
推論(算数)— 3モデルとも正解、検算まで自発的にやる
出題はこの文章題です。
ある店ではリンゴを1個120円、みかんを1個80円で売っています。太郎さんはリンゴとみかんを合わせて15個買い、合計1560円を支払いました。太郎さんが買ったリンゴの個数を求めてください。
27B Q4_K_M(4bit・一番「劣化」が心配な構成)の実際の出力がこちら。
リンゴを x 個、みかんを y 個買ったとします。(中略)
120x + 80(15 − x) = 1560
120x + 1200 − 80x = 1560
40x = 360
x = 9したがって、リンゴは9個買いました。
検算のため、みかんの個数も確認します。
y = 15 − 9 = 6 個
金額:120 × 9 + 80 × 6 = 1080 + 480 = 1560 円
条件に合致しています。答え: 9個
正解(9個)に加えて、頼んでいない検算まで自発的にやっています。MoE版は「1. 変数の設定 → 2. 方程式の作成 → 3. 連立方程式を解く → 4. 検算」と見出し付きで最も構造化された解答、Q8版は別の解き方でこちらも正解。4bit量子化による推論力の劣化は、少なくともこのレベルの問題では観測できませんでした。
日本語要約 — 全モデルの出力を並べる
約600字のローカルLLM解説文を「120字程度で要約せよ」というタスク。3モデルの実際の出力を全文並べます。
27B Q4_K_M(149字):
生成AI普及で関心が高まるローカルLLMは、クラウドAPIと違い追加料金なしで利用でき、機密データを手元で処理できるためコスト・プライバシー面で優れる。ただし、高性能モデルはメモリを多く必要とするため、4ビット量子化などの圧縮技術で容量を削減し、適切なハードウェア選定を行うことが実用化の鍵となる。
27B Q8_0(153字):
生成AIの普及で関心が高まるローカルLLMは、クラウドAPIと違い追加料金なしで利用でき、機密データを手元で処理できるためコスト・プライバシー・自由度に優れる。ただし、高性能モデルはメモリを多く必要とするため、4ビット量子化などの圧縮技術で容量を削減し、適切なハードウェアを選定することが実用化の鍵となる。
MoE 35B-A3B(175字):
生成AIの普及で、個人端末で動作する「ローカルLLM」への関心が高まっている。クラウド利用と比べ、追加料金なしで利用でき、機密データの外部流出を防げる点が魅力だ。課題はハードウェアだが、量子化技術でメモリ節約が可能となり、中古GPUでも実用的な速度が得られる。コスト・プライバシー・自由度の面で優れ、適切なハードウェア選定と技術理解が鍵となる。
面白いのはQ4とQ8の出力がほぼ同一なこと(違いは「面で優れる」→「・自由度に優れる」程度)。量子化の影響がここでも見えません。MoEはやや長めですが「中古GPUでも実用的な速度」という原文の要素まで拾っていて、一番網羅的でした。3つとも原文にない情報の混入(ハルシネーション)はゼロです。
コード生成 — 3モデルとも一発で動くToDoアプリを出した
お題は「外部ライブラリ禁止・単一HTMLで動くToDoアプリ(追加/完了トグル/削除/localStorage永続化)」。生成されたコードをそのままブラウザで開いて実機検証しました。3モデルとも一発で全機能が動きました。
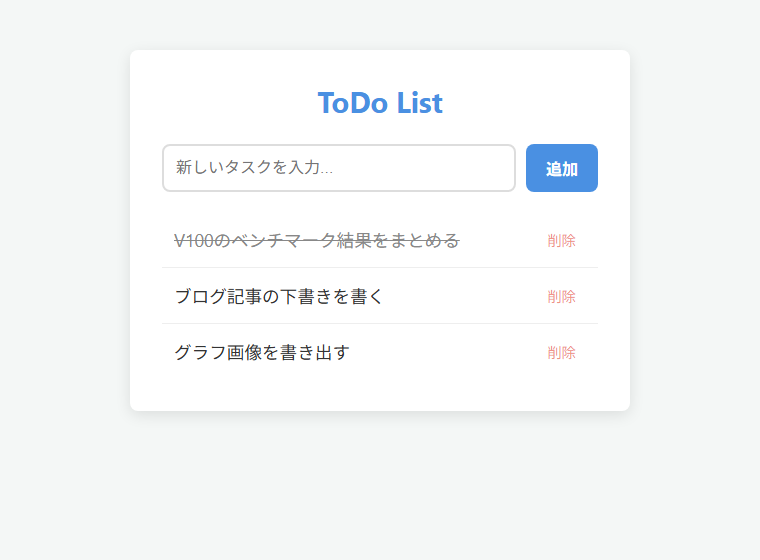
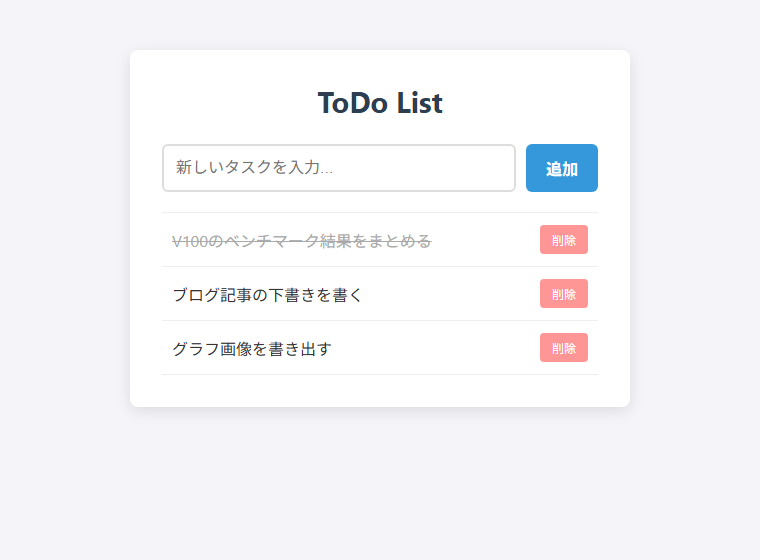
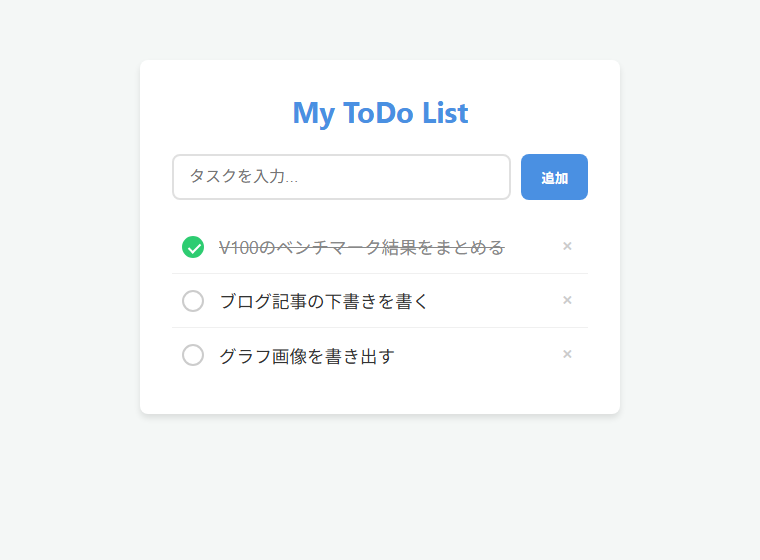
確認した動作は「追加ボタンでタスク追加」「クリックで完了トグル(打ち消し線)」「削除」「リロードしても残る(localStorage保存)」の4点で、3モデルとも全部パス。意外だったのは一番速いMoEのUIが一番洗練されていたことです。完了時に緑のチェック円が付き、余白も整っていて「速いけど雑」ということは全くありません。コードの中身も綺麗で、MoE製アプリのJS部分を一部抜粋するとこんな感じです。
// 状態管理(localStorageから読み込み)
let todos = JSON.parse(localStorage.getItem('todos')) || [];

// タスク完了トグル関数
function toggleTodo(id) {
    todos = todos.map(todo => {
        if (todo.id === id) {
            return { ...todo, completed: !todo.completed };
        }
        return todo;
    });
    saveAndRender();
}

// 保存と再描画
function saveAndRender() {
    localStorage.setItem('todos', JSON.stringify(todos));
    renderTodos();
}
スプレッド構文でのイミュータブル更新、状態と描画の分離と、人が書くコードレビューでも文句のつけようがない書き方です。
長文生成 — 1200〜1500字の構成された記事が出てくる
「個人がローカルでLLMを動かす意義」というテーマで1200〜1500字のブログ記事を書かせるタスク。27B Q4の書き出しを抜粋します。
近年、ChatGPTやClaudeといった大規模言語モデル(LLM)の進化は目覚ましいものがあります。しかし、クラウドベースのAPIに依存するだけでなく、自らのPCやサーバー上でLLMをローカル環境で動かす動きが個人開発者や研究者の間で急速に広がっています。(中略)個人がローカルLLMを運用することには、データプライバシーの確保、カスタマイズ性の向上、そして技術的リテラシーの深化という、現代のデジタル社会において極めて重要な意義が存在します。
この後「第一に(データ主権)→第二に(ドメイン最適化とオフライン自律性)→第三に(ブラックボックス化への抵抗)→結論」と、弁護士の機密文書やLoRAでの文体学習といった具体例を交えつつ導入・本論・結論がきっちり構成されていました。3モデルとも構成は崩れず、Q8版が最も見出しの立て方が明快、という結果です。
ひとつ注意点として、Qwen 3.6は常時思考(thinking)モデルなので、生成上限トークンを小さくすると思考の途中で出力が切れます。実際、速度計測時(thinking ON・上限固定)は全タスクが上限到達で途切れました。実用時は上限を大きめに取るのが前提です(前回のM1 Max検証と同じクセ)。
検証結果④ M1 Max 64GBとのクロス比較 — V100が約1.6〜2.0倍速
前回のM1 Max実測と同一4タスクでの比較です。

| モデル | M1 Max 64GB MLX (4bit) | V100 32GB llama.cpp (Q4_K_M) | 速度比 |
|---|---|---|---|
| dense 27B | 16.7 tok/s | 32.9 tok/s | V100が約2.0倍速 |
| MoE 35B-A3B | 61.2 tok/s | 98.8 tok/s | V100が約1.6倍速 |
量子化方式が異なる(MLXのnvfp4 vs GGUFのK-quant)ため厳密な同条件ではありませんが、「実用4bit同士の体感差」としてはV100が約1.6〜2.0倍速い結果でした。2017年のGPUが2021年のApple Silicon最上位を実測で上回るのは、やはりHBM2の帯域約900GB/s(M1 Maxは400GB/s)が効いていると見ています。LLM推論は結局メモリ帯域ゲームです。
一方でM1 Maxには64GBを丸ごと使える強みがあり、V100の32GBでは収まらないQ8の長コンテキストや、より大きいモデルはM1 Max側に軍配。「速さのV100、余裕のユニファイドメモリ」という住み分けがはっきりしました。
最大の罠 — プリビルドllama.cppはもうVoltaで動かない
ここが今回いちばん伝えたい点です。最初、配布されているllama.cppのプリビルドバイナリでモデルをロードしたところ、最初のトークンを生成しようとした瞬間にクラッシュしました。
ggml-cuda.cu:104: CUDA error
CUDA error: no kernel image is available for execution on the device
原因を調べると、プリビルドバイナリのビルド対象アーキテクチャは ARCHS = 750,800,860,890,900,1000,1200。つまりsm_75(Turing世代)以降のみで、V100のsm_70(Volta)は対象外。V100用のGPUカーネルがバイナリに存在しないのです。
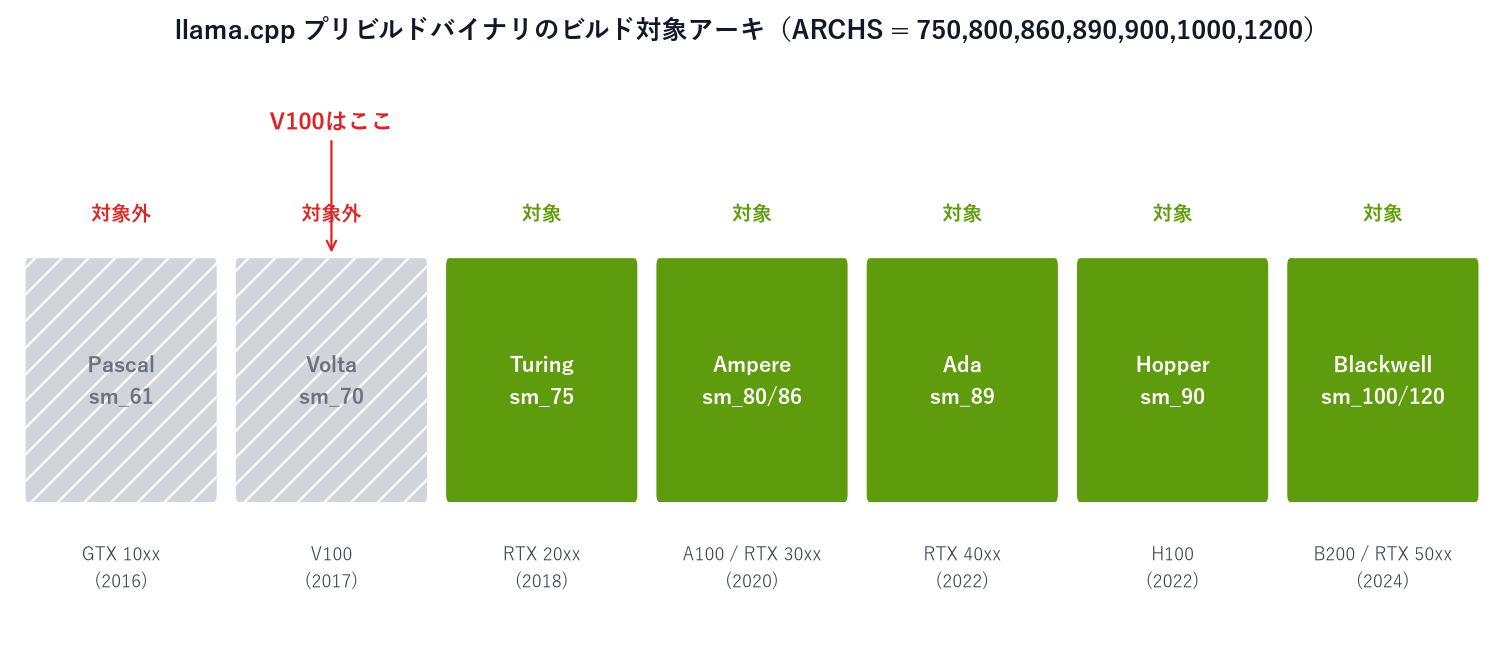
対処は、ソースからsm_70を明示してビルドし直すこと。これで全モデルが問題なく動きました。
apt-get install -y libcublas-dev-12-9
git clone --depth 1 https://github.com/ggml-org/llama.cpp
cmake -B build -DGGML_CUDA=ON -DCMAKE_CUDA_ARCHITECTURES=70 -DLLAMA_CURL=ON -DCMAKE_BUILD_TYPE=Release
cmake --build build -j"$(nproc)" --target llama-server llama-cli llama-bench
ただし、ビルド中にCUDAコンパイラ(nvcc)自身がこう警告してきます。
Support for offline compilation for architectures prior to ‘sm_75’ will be removed in a future release
CUDAツールキット側でも、Volta向けコンパイルの打ち切りが予告されているということです。今日は自前ビルドで完璧に動きますが、エコシステムがVoltaを見捨てつつあるのは間違いない。V100を買うなら「セットアップに一手間かかる」「将来どこかで最新版ソフトが使えなくなる」リスクを織り込む必要があります。「2026年、旧世代GPUは”すぐ動く状態”では手に入らない」ことを身をもって体験しました。
コスパ分析 — 13.6万円のV100は「買い」か
さて本題のコスパです。2026年7月時点、AliExpressでTesla V100 32GBのPCIe版は135,751円(ファン付きモデル)で買えます。
Tesla V100 32GB(PCIe・ファン付き)— 135,751円(AliExpress)
この価格をどう評価するか、実測値と合わせて整理します。
| 観点 | 実測・計算値 |
|---|---|
| VRAM単価 | 135,751円 ÷ 32GB ≒ 約4,200円/GB |
| 実用速度 | 27B級で33 tok/s、MoE 35Bで99 tok/s(本記事の実測) |
| 電気代(フル負荷時) | ピーク約300W → 約9円/時間(31円/kWh換算)。24時間フル稼働で月約6,700円 |
VRAM 32GBを約4,200円/GBで買える現行の選択肢はほぼ唯一です。同価格帯のライバルは中古RTX 3090(24GB)あたりですが、VRAMは8GB少ない。RTX 4090(24GB)は速度・将来性で圧倒するものの価格は倍以上します。「Q4_K_Mの27B級を23.4GBで余裕を持って載せ、まだ8GB以上残る」という本記事の実測が示すとおり、32GBという容量そのものがV100の商品価値です。逆に速度の絶対値で言えば、MoEで99 tok/sも出るので日常用途で不足を感じる場面はまずありません。
買う場合の注意点が2つあります。
① 冷却。V100はサーバーの強制エアフローで冷やす前提の設計で、カード単体にファンがありません。実測でもフル負荷時72〜78°C(サーバー冷却あり)まで上がっており、普通のPCケースに挿すならファン付きモデル一択です。素のファンなしカードも出回っていますが、こちらはラックサーバーに組み込む人や、自作ダクト+ブロワーファンで冷却を工作できる人向けです。
NVIDIA Tesla V100 32GB(PCIe・ファンなし)はこちら(AliExpress)
② フォームファクタ。中古を漁るときは必ずPCIe版を選んでください。SXM2版はNVLink接続の専用マザーボードが必要で、通常のPCには物理的に挿せません(相場がやたら安いSXM2はこれが理由です)。また映像出力が無いので、画面用に別途iGPUか安いグラボが要ります。
まとめると、「32GB VRAMを最安で手に入れて、27B級ローカルLLMを実用速度で回す推論専用機」と割り切れるなら13.6万円の価値は実測で裏付けられる、というのが結論です。ただし前章のVolta切り捨て問題があるので、「買って挿せばすぐ動く」を期待する人には向きません。
向いている人・注意点
向いている人:
- VRAM 32GBのCUDA機を10万円台で確保して、27B級ローカルLLMを実用速度(33〜99 tok/s)で回したい人
- クラウドAPIに出せない機密データをローカルで処理したい人
- 自前ビルドやドライバ設定を「楽しめる」自作・サーバー好きの人
注意点:
- プリビルドのllama.cppは動きません。sm_70指定の自前ビルドが必須で、CUDA側もVoltaサポート打ち切りを予告済み。エコシステムの残り寿命は織り込むこと
- Q8_0は29.2GBで32GBギリギリ。長コンテキストを使うならQ4_K_M推奨
- 映像出力なし・冷却はサーバー前提。自宅ならファン付きモデルを、SXM2版ではなくPCIe版を
- フル負荷時250〜300W。電気代(フル稼働で約9円/時間)と夏場の熱は覚悟
- Qwen 3.6は常時思考。生成上限トークンは大きめに設定する
まとめ
Tesla V100 32GBでQwen 3.6を実測した結論です(すべて実測値)。
- MoE 35B-A3B(4bit) = 98.8 tok/s。dense 27B(32.9 tok/s)の約3倍速で、M1 Max 64GBの約1.6〜2.0倍速
- 品質も問題なし。算数は3モデルとも正解+自発的に検算、生成したToDoアプリは3本とも実機で全機能動作、要約・長文も破綻ゼロ
- Q4_K_MならVRAM 23.4GBで余裕、Q8_0は29.2GBでギリギリ。MoEは206Wと省電力
- 最大の罠はVolta切り捨て。llama.cppは自前ビルド必須で、将来の互換性リスクあり
- 13.6万円で32GB VRAM(約4,200円/GB)は唯一無二。推論専用機と割り切れるなら「買い」、プラグアンドプレイを求めるなら「見送り」
「2017年のGPUはもう遅い」は実測で完全に否定されました。速度だけなら今でも一線級です。ただし「速いかどうか」より「これからも動かし続けられるか」が旧世代GPUの本当の検討ポイントだった、というのが今回いちばんの学びです。
検証ノート(再現用)
本記事の数値はすべてTesla V100-SXM2-32GB実機での実測です。再現手順は以下のとおり。
環境: Tesla V100-SXM2-32GB / ドライバ 580.159.03 / CUDA 12.9 / llama.cpp(sm_70自前ビルド)
# 1) llama.cpp を sm_70 (Volta) 向けにビルド ※プリビルド版はV100で動かない
apt-get install -y libcublas-dev-12-9
git clone --depth 1 https://github.com/ggml-org/llama.cpp
cmake -B build -DGGML_CUDA=ON -DCMAKE_CUDA_ARCHITECTURES=70 -DLLAMA_CURL=ON -DCMAKE_BUILD_TYPE=Release
cmake --build build -j"$(nproc)" --target llama-server llama-cli llama-bench

# 2) サーバ起動(例: 27B Q4_K_M)
./build/bin/llama-server -hf unsloth/Qwen3.6-27B-GGUF:Q4_K_M -ngl 999 -c 16384 --port 18001

# 3) OpenAI互換APIで計測(レスポンスの timings に prefill/decode tok/s が入る)
curl -s http://127.0.0.1:18001/v1/chat/completions -H 'Content-Type: application/json' \
  -d '{"messages":[{"role":"user","content":"..."}],"max_tokens":512,"temperature":0}'
計測値(平均decode・実測): 27B Q4_K_M = 32.9 tok/s(ピーク23.4GB・308.6W)/ 27B Q8_0 = 23.4 tok/s(29.2GB・292.4W)/ 35B-A3B UD-Q4_K_M = 98.8 tok/s(27.0GB・206.2W)。各タスク2回ウォーム実行の最終run採用、temperature=0、context 16384。
既知の制約: 速度計測はthinking ON(既定)のため全タスクが生成上限に到達し出力は途中で切れる。品質評価は別途thinking OFF(enable_thinking:false + /no_think)で完全出力を取得して実施。TTFTはストリーミング値が常時思考の影響で不安定なためprefill時間を採用。計測個体はSXM2版(ブースト1530MHz)で、PCIe版(1380MHz)は1割弱遅い可能性。温度72〜78°Cはサーバー冷却前提の値。MoEはunsloth dynamic量子化(UD-Q4_K_M)を使用(素のQ4_K_Mが未配布のため)。ToDoアプリのスクリーンショットは生成コードを無改変で開き、タスクを投入した状態のもの。
こちらの記事を拝見し、手元にTesla V100 32GBを用意してイチから環境構築を試み、昨日ついにllama-serverでqwen3.6_35B_A3B_Unsloth_Q5_K_XL_GGUFの立ち上げに成功しました!
元々この構成でのローカルllmを組もうと考えていたところに、実際に動作させた結果を公表していただいた事で大いに勇気づけられ、実現に至ったことが本当に嬉しく、ここにご報告させて頂きます。
この記事に心より感謝申し上げるとともに、今後のご活躍と、さらなる興味深い記事を楽しみにしております。ありがとうございました。