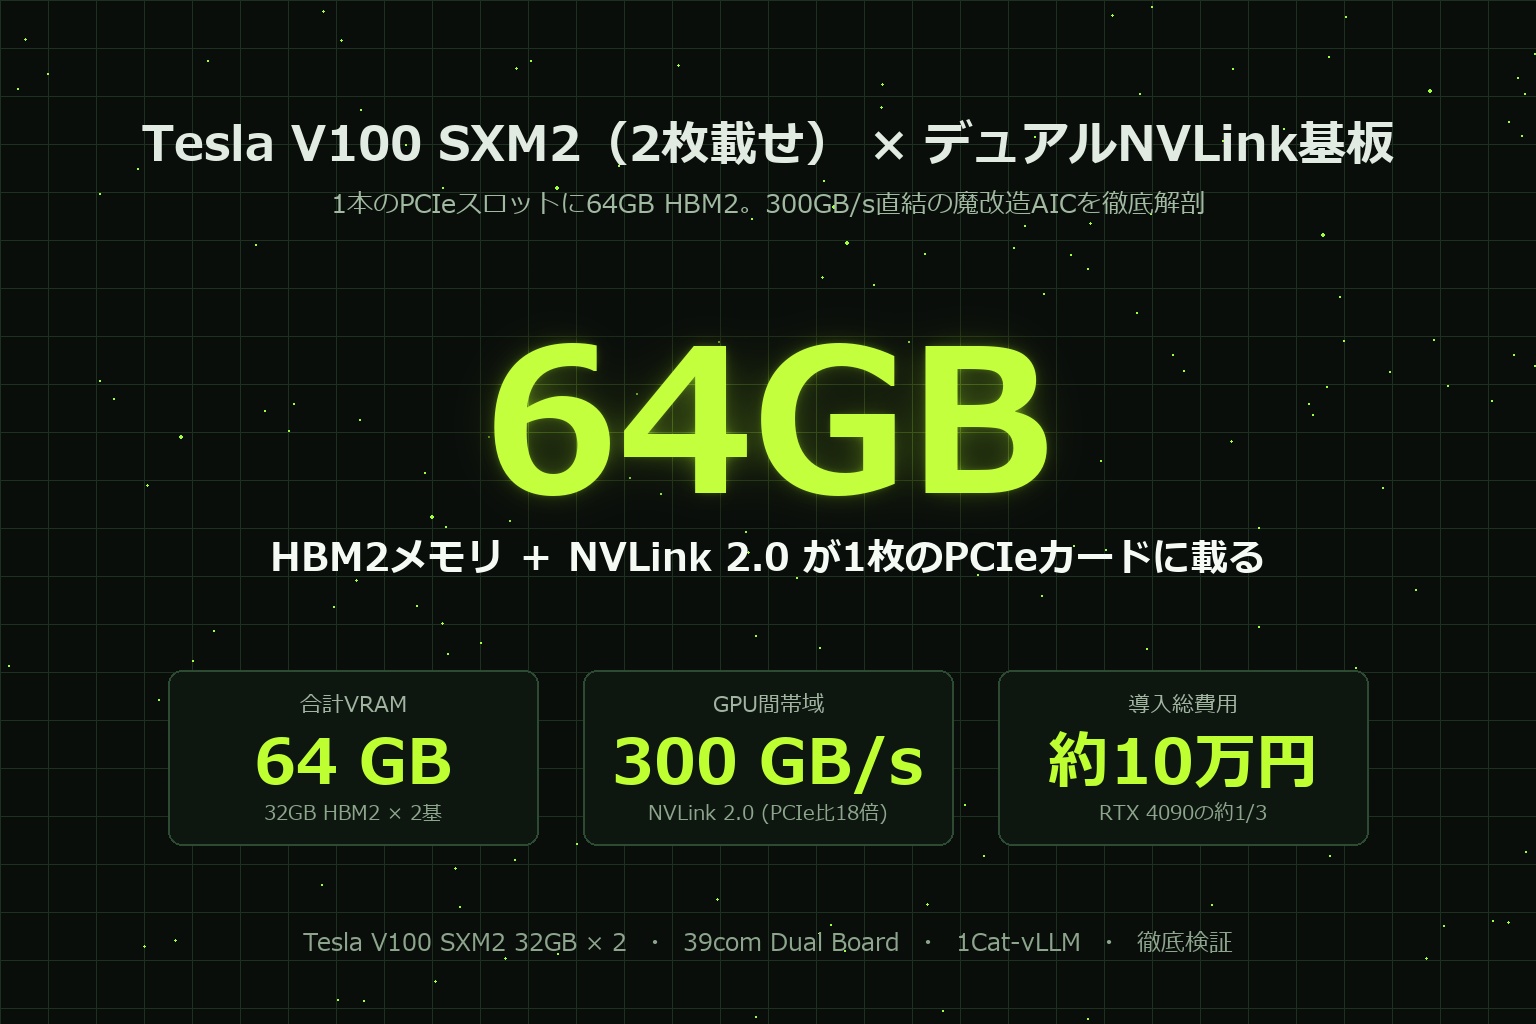
こんにちは、七宮さん(@shichinomiya_s) です。
これまで本ブログでは、Tesla V100 32GBでQwen3.8-27Bを動かす検証や、MoE 35Bを動かす実測ベンチマークなど、エンタープライズ中古GPUを活用した超高コスパなローカルLLM環境を追求してきました。
そんな中、AliExpressの深淵を巡回していたところ、思わず二度見してしまうとんでもない魔改造ボードを発見しました。
それが今回紹介する、「Tesla V100 SXM2 デュアルGPU NVLinkアダプターボード(300GB/s)」です。
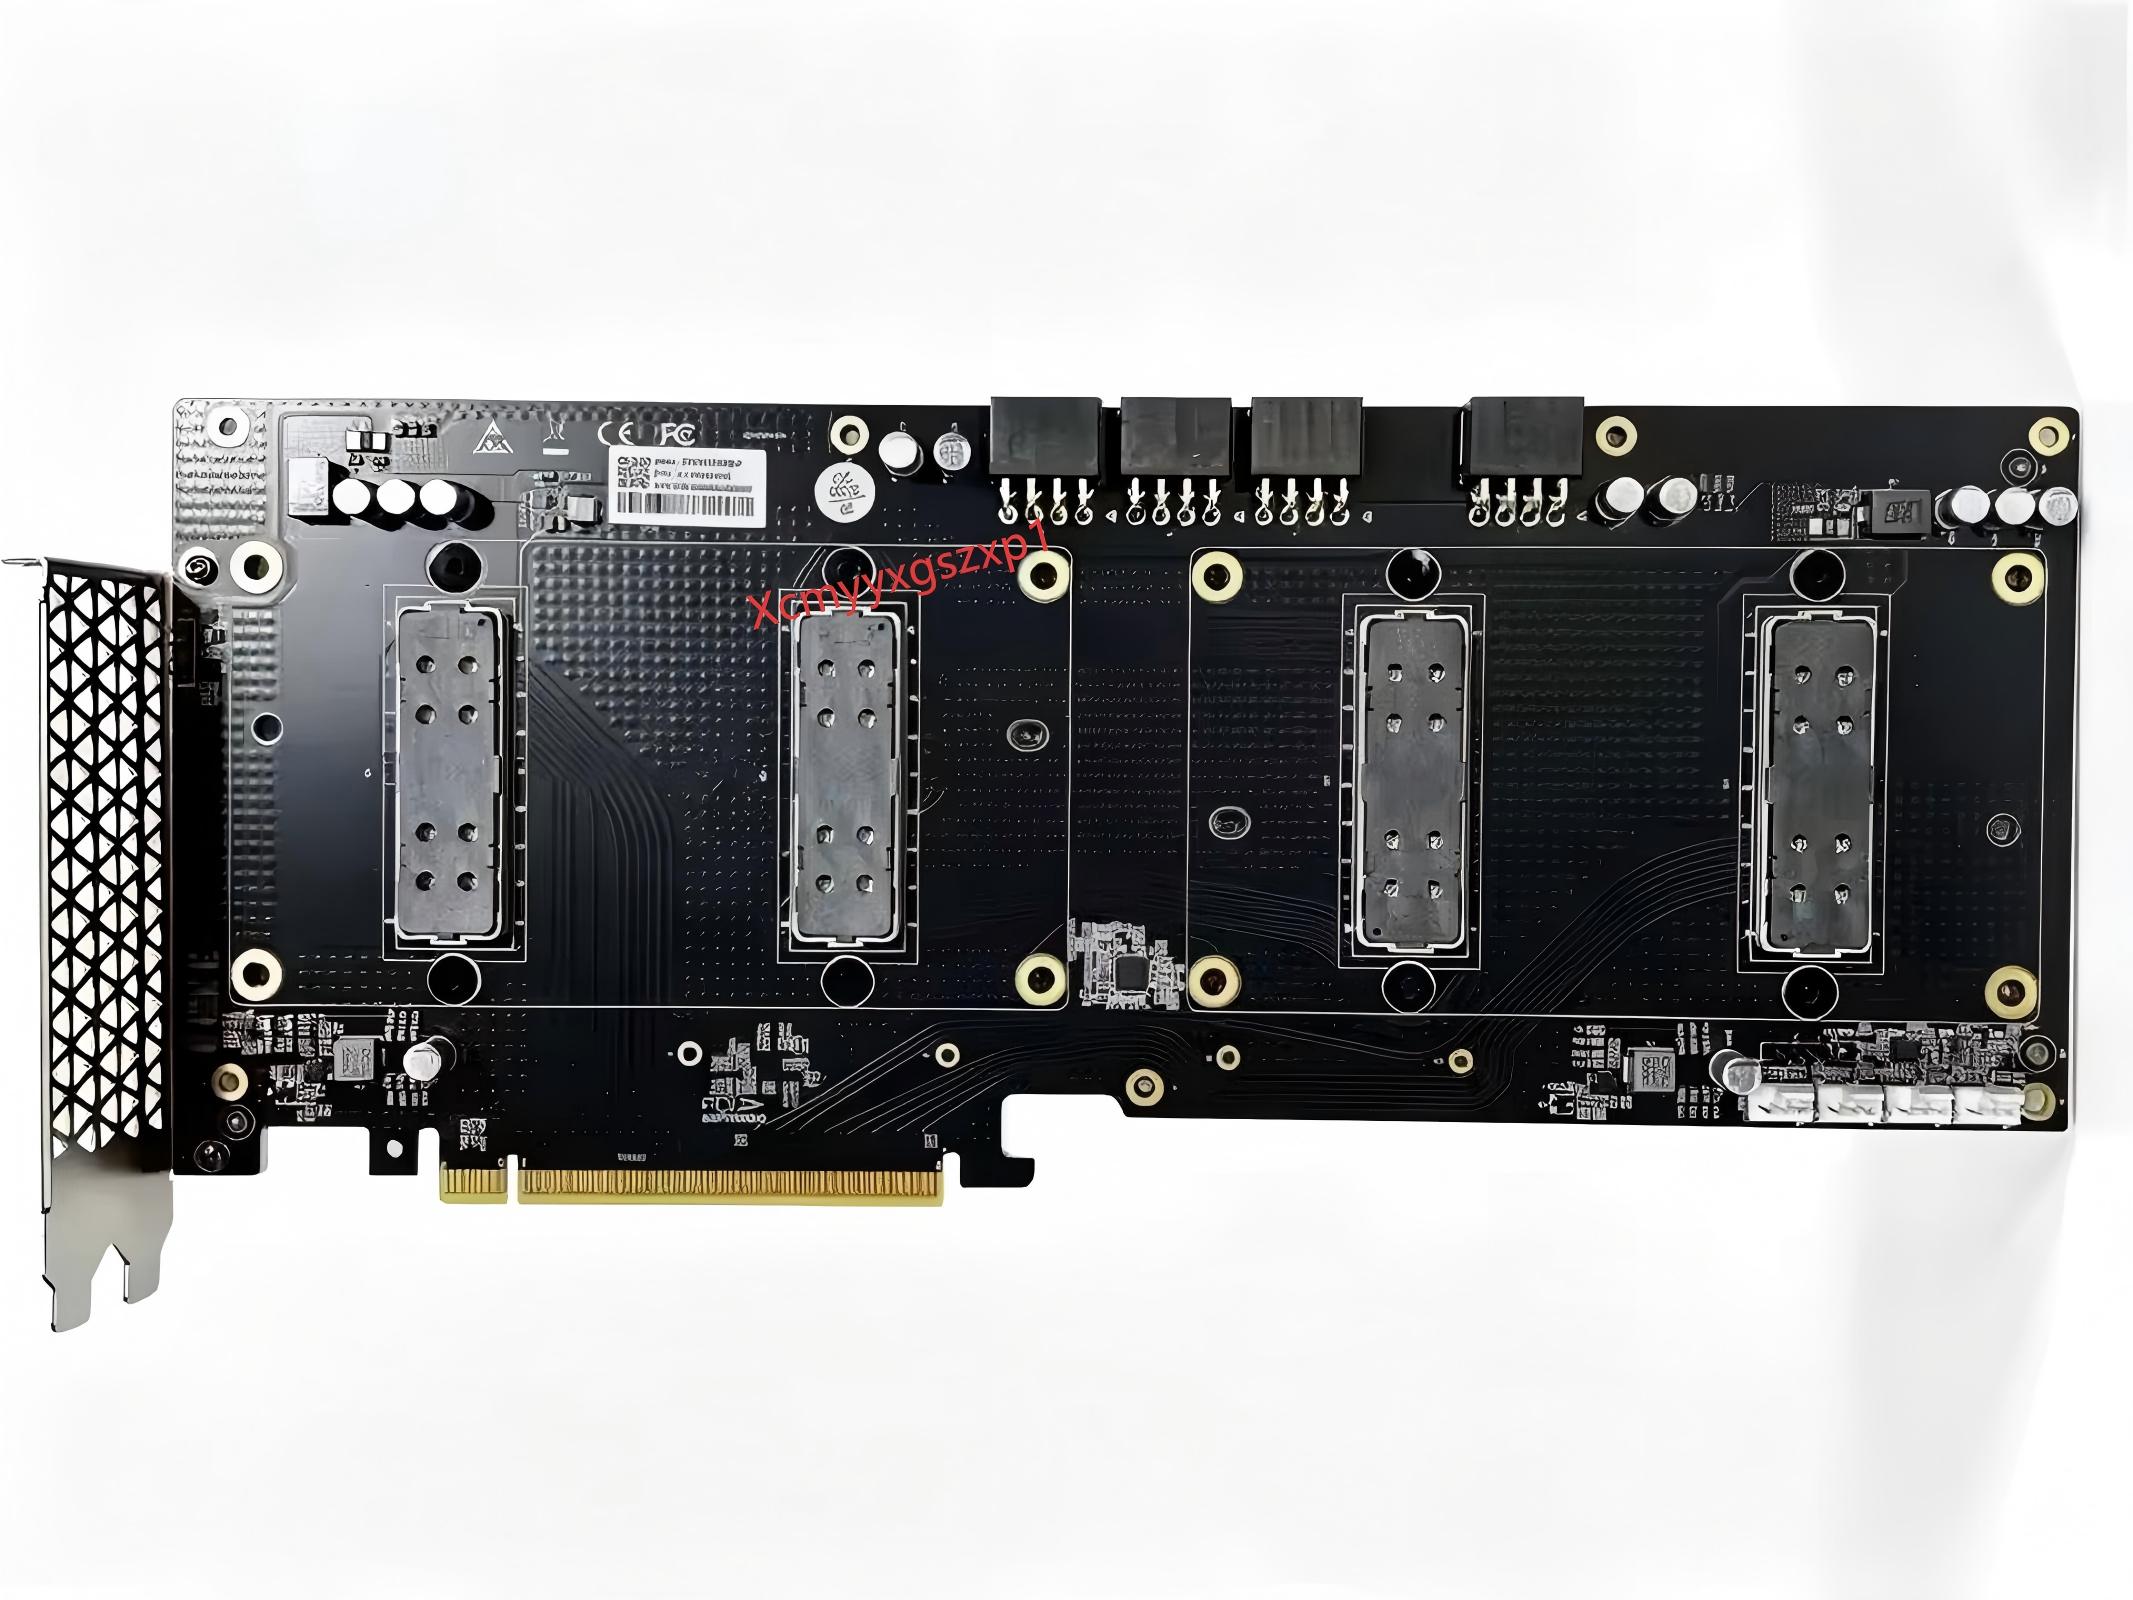
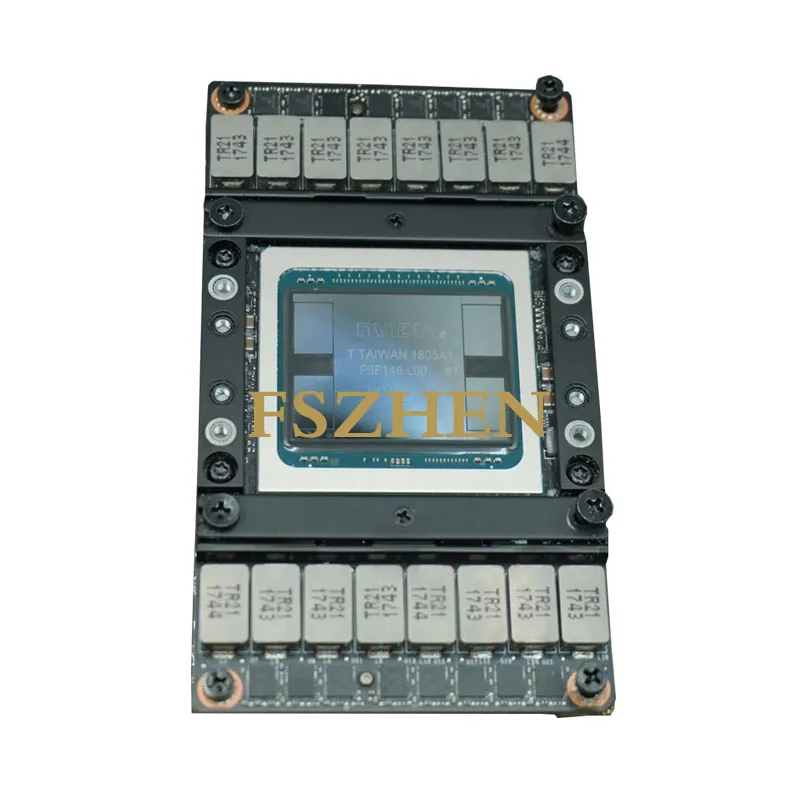
なんと、本来は専用サーバー(DGX-1等)の奥底にマウントされるはずの「Tesla V100 SXM2」を2枚、同一の基板上に直載せし、基板上のPCBトレースでNVLink 2.0(300GB/s)を直結。さらに裏面にPLX PCIeスイッチチップを搭載することで、民生用PCのPCIe x16スロット1本に挿すだけで動いてしまうという、狂気とロマンの結晶のようなアドインカード(AIC)です。
「本当に動くのか?」「冷却はどうする?」「最新LLMは動くのか?」「総額いくらで作れるのか?」——。
中国のハードウェアフォーラム(Taobao、閑魚、Bilibili、CSDN)や海外HPCコミュニティ(r/LocalLLaMA、ServeTheHome)の一次情報を徹底的に洗い出しましたので、その全貌を余すところなくレポートします。
実測サマリー — 1本のPCIeスロットに64GB HBM2と300GB/s NVLinkが載る
まずは要点とスペックの結論から整理します。
| 項目 | スペック / 実態 | 技術的メリット |
|---|---|---|
| 搭載GPU | Tesla V100 SXM2 × 2基 | 16GB×2(計32GB)または 32GB×2(計64GB HBM2) |
| メモリ帯域 | 各900GB/s(合計 約1.8 TB/s) | GDDR6Xを遥かに凌駕するHBM2の圧倒的メモリバス幅 |
| GPU間接続 | NVLink 2.0 直結(双方向 300 GB/s) | PCIe Gen3 x16(約16GB/s)の約18倍。TP=2の通信遅延が極小 |
| ホスト接続 | PCIe 3.0 x16 スロット ×1 | PCIe 4.0 / 5.0 スロットでも下位互換でそのまま動作 |
| PCIeスイッチ | Broadcom / PLX PEX8747(または8749)直載せ | 「免拆分」=マザーボードのBifurcation(分岐機能)が不要! |
| 電源入力 | PCIe 8-pin × 4基(最大600W) | SXM2の最大TDP 300W×2を外部電源から余裕を持って供給 |
| ファン端子 | オンボード 4-pin PWM × 4基 | クーラー用ファンをカード本体から直結給電可能 |
| 概算総費用 | 約10万〜11万円(64GB構成時) | RTX 4090(24GB・約30万円)の1/3の価格で64GB環境が手に入る |
このカードの正体 — 中国HPC工房「39com」が作ったデュアルSXM2 AIC
このボードを手掛けたのは、中国の熱狂的なAIハードウェア開発集団「39com」(および1CATai / 一猫之下のエコシステム)です。
これまではSXM2を1枚だけPCIeに変換する基板が主流でしたが、V100 SXM2の最大の武器である「NVLink」が使えず、単なるPCIe版V100の劣化互換にとどまっていました。
そこで彼らがリバースエンジニアリングによって開発したのが、この「デュアルSXM2+NVLink直結基板」です。
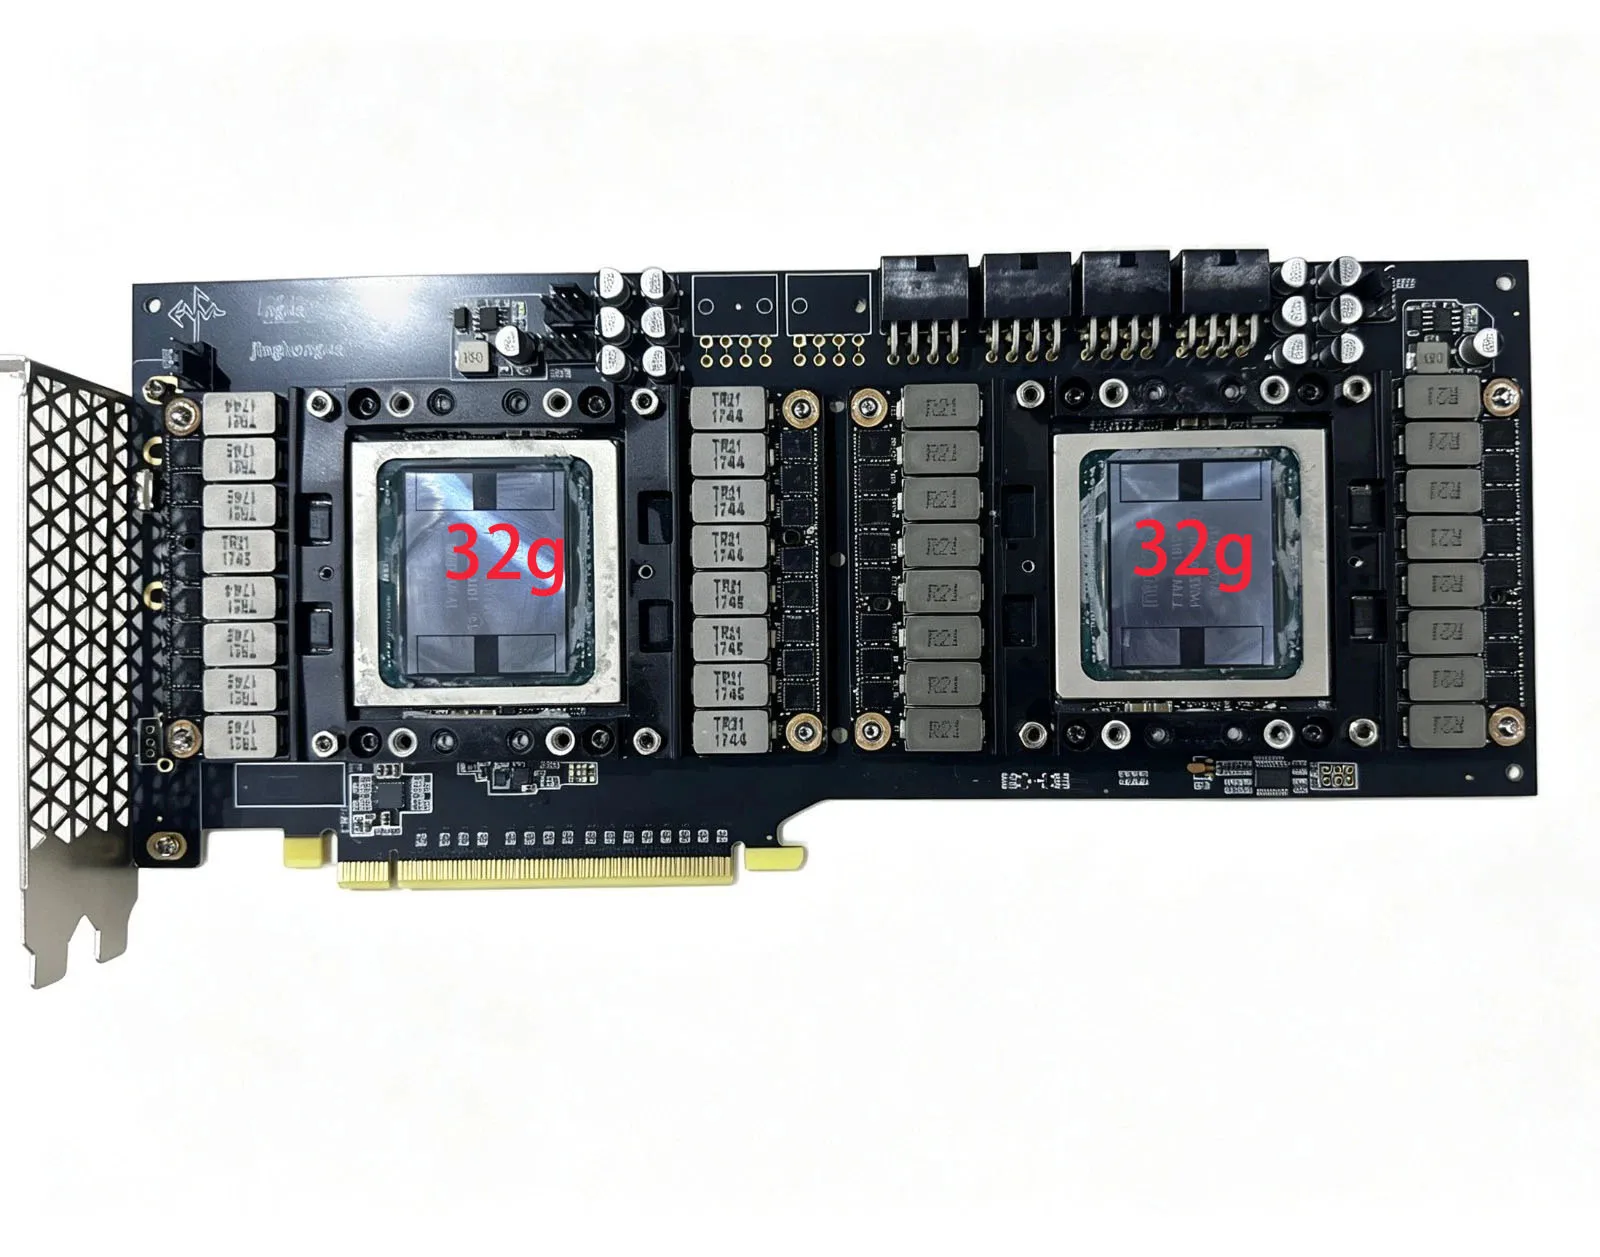
ハードウェア回路の徹底チェック — なぜPCIe分岐不要で動くのか
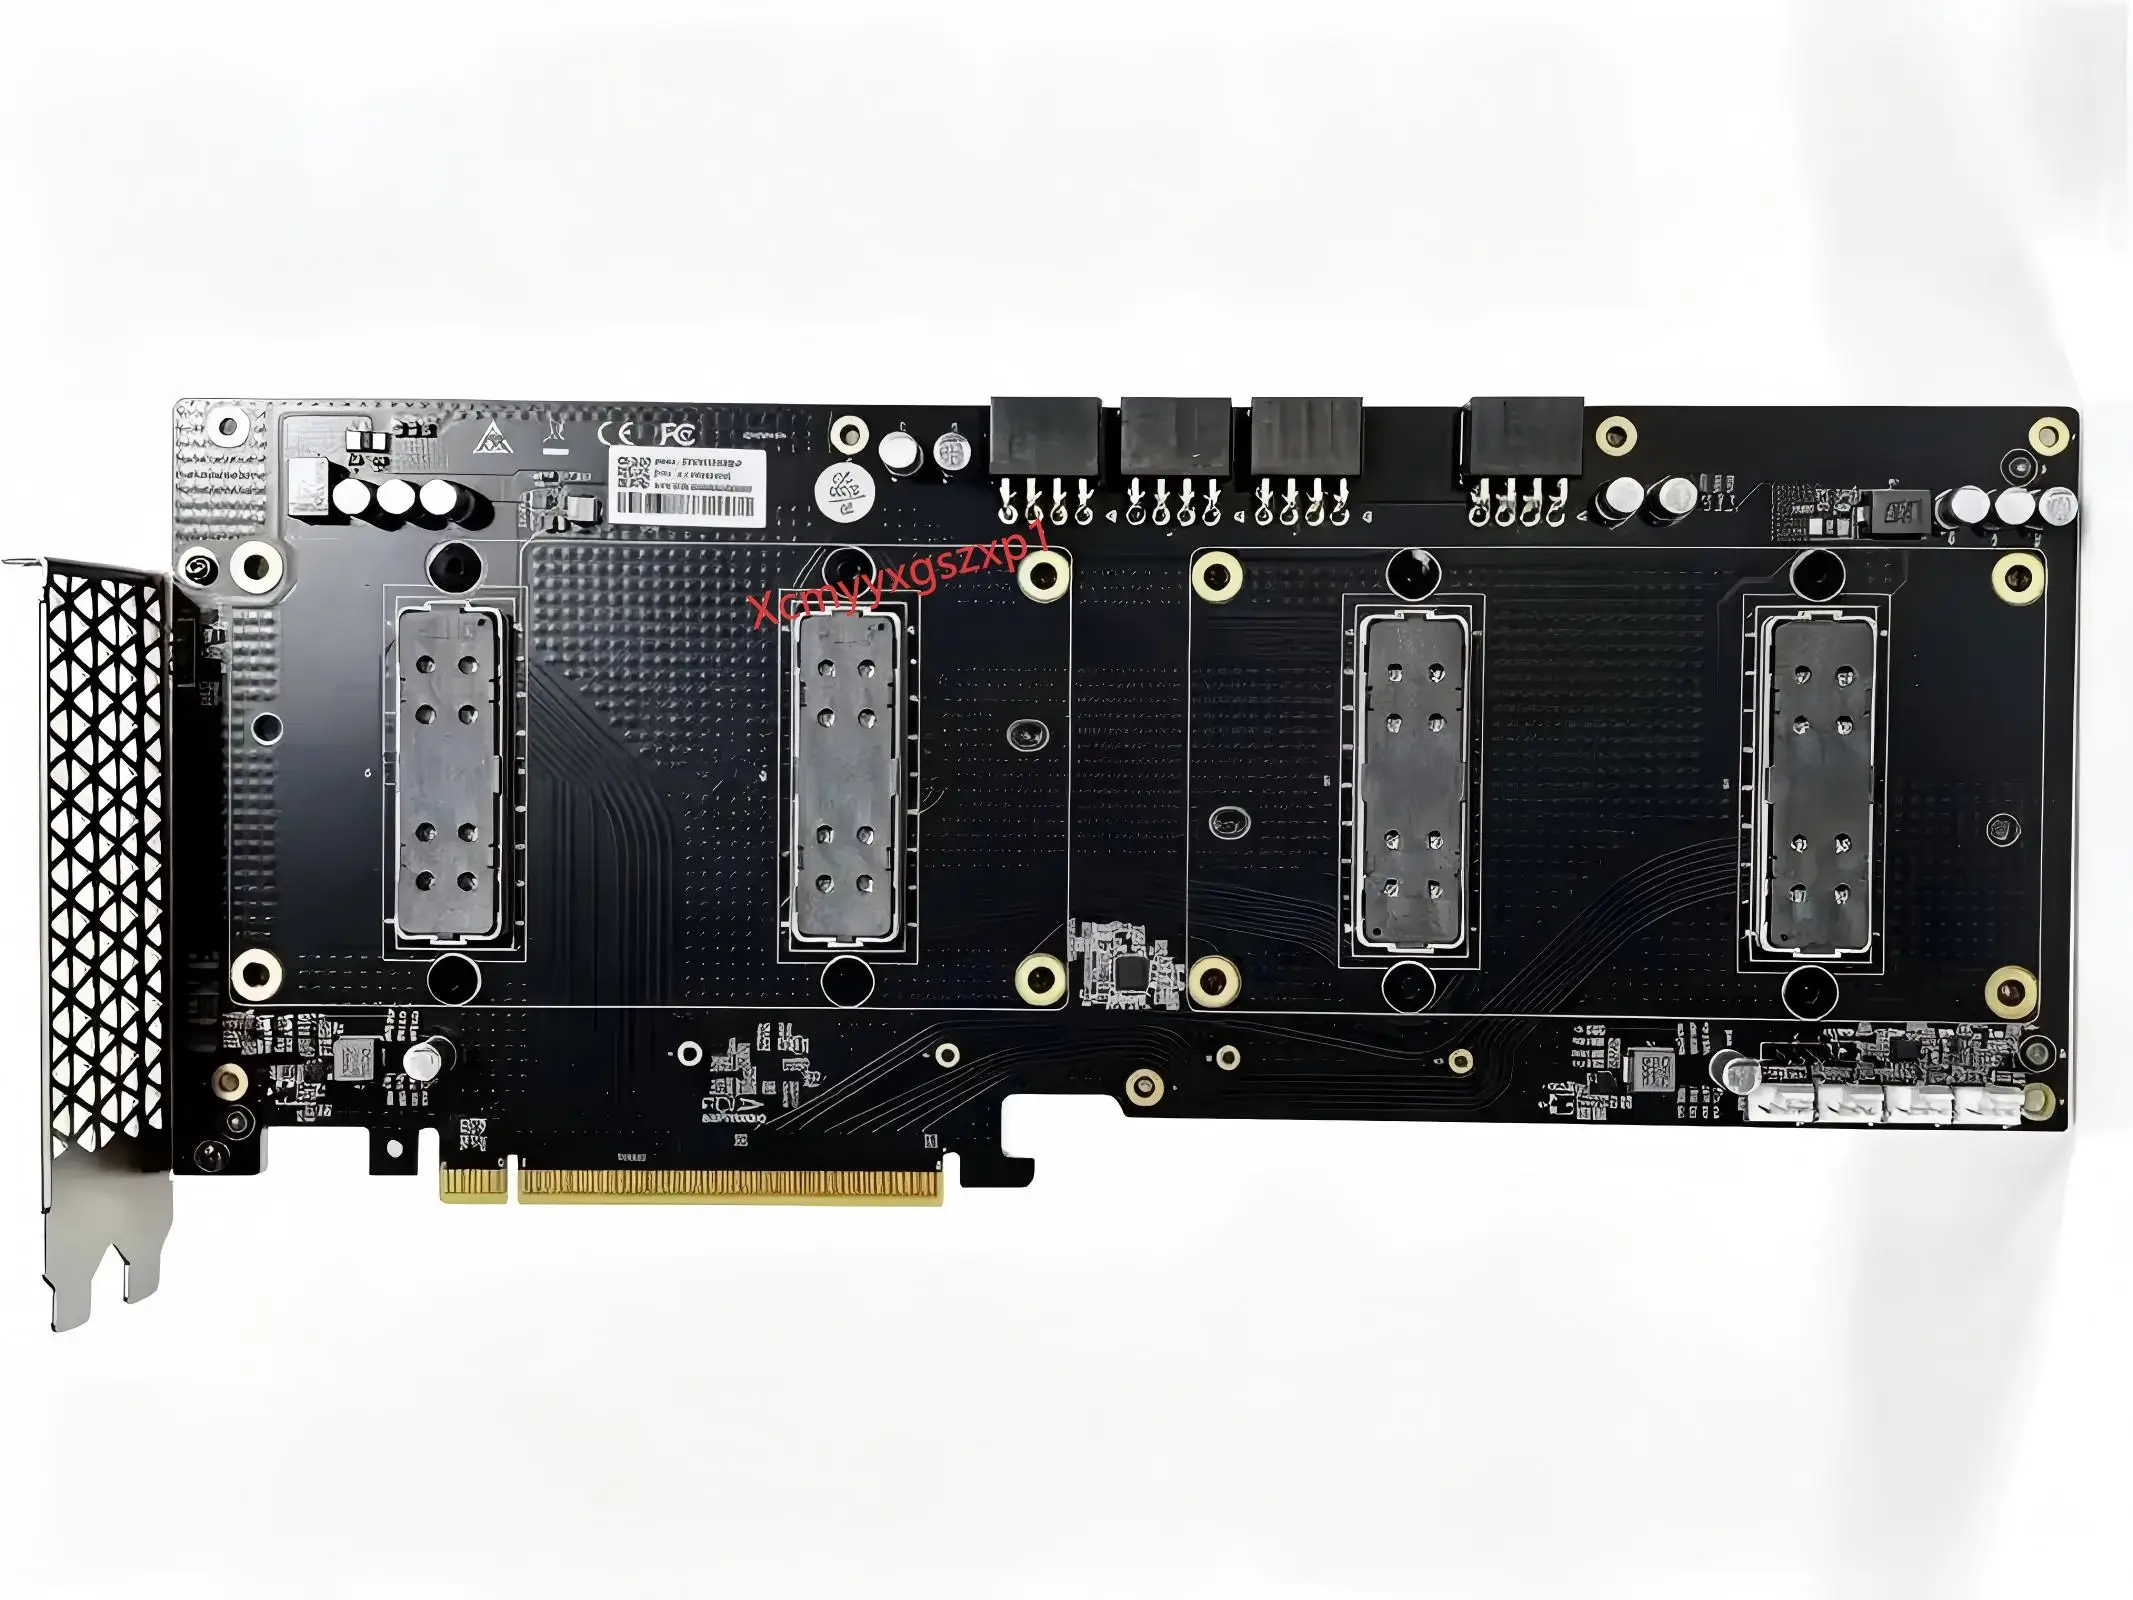
基板の高解像度写真を拡大し、実装されている回路とチップを解析しました。
① オンボードPLXチップ(PEX8747/8749)による「免拆分」
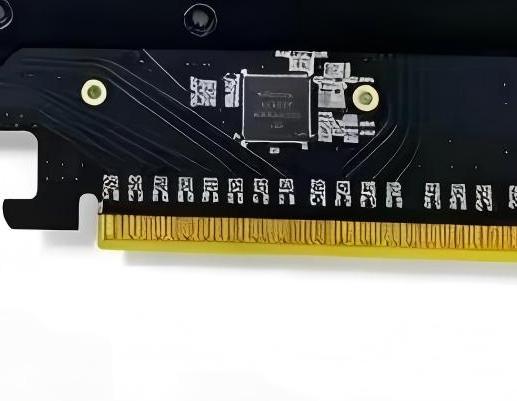
基板裏面のPCIe金手指のすぐ上に、Broadcom/PLXのPCIeスイッチチップ(PEX8747またはPEX8749)が鎮座しています。
中国の販売ページで「免拆分(No-Bifurcation)」と大々的にアピールされている秘密はここにあります。
通常、1スロットから2枚のGPUを認識させるには、マザーボードのBIOSで「PCIe Bifurcation(x8 + x8分岐)」を有効にする必要があります。しかし、安価なB650マザーやIntel B760マザー、BTOパソコンのマザーボードは分岐に対応していないことが大半です。
このカードはオンボードのPLXスイッチが自前でパケットスイッチングを行うため、どんなマザーボードに挿してもOSから2基の独立したV100として即座に認識されます。
② 基板内PCB多層配線によるNVLink 2.0(300GB/s)直結
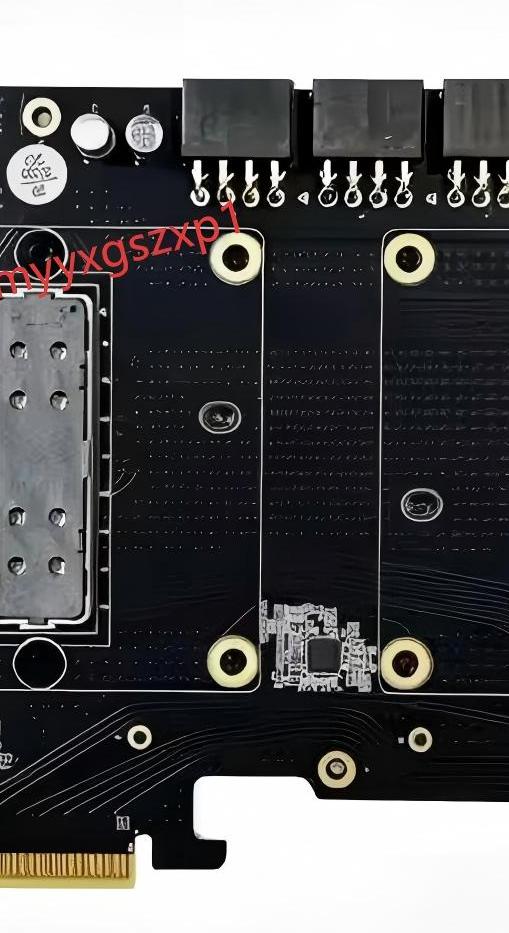
2つのSXM2ソケットの間には、息を呑むほど美しい高密度な蛇行配線(等長差動ペア配線)が整然と走っています。
外付けのNVLinkブリッジやリボンケーブルを挿す必要は一切ありません。カード上にモジュールをネジ止めするだけで、物理的に全6リンク(双方向300GB/s)が自動結線されます。
③ 8-pin × 4基(最大600W)の電源と4系統ファン端子
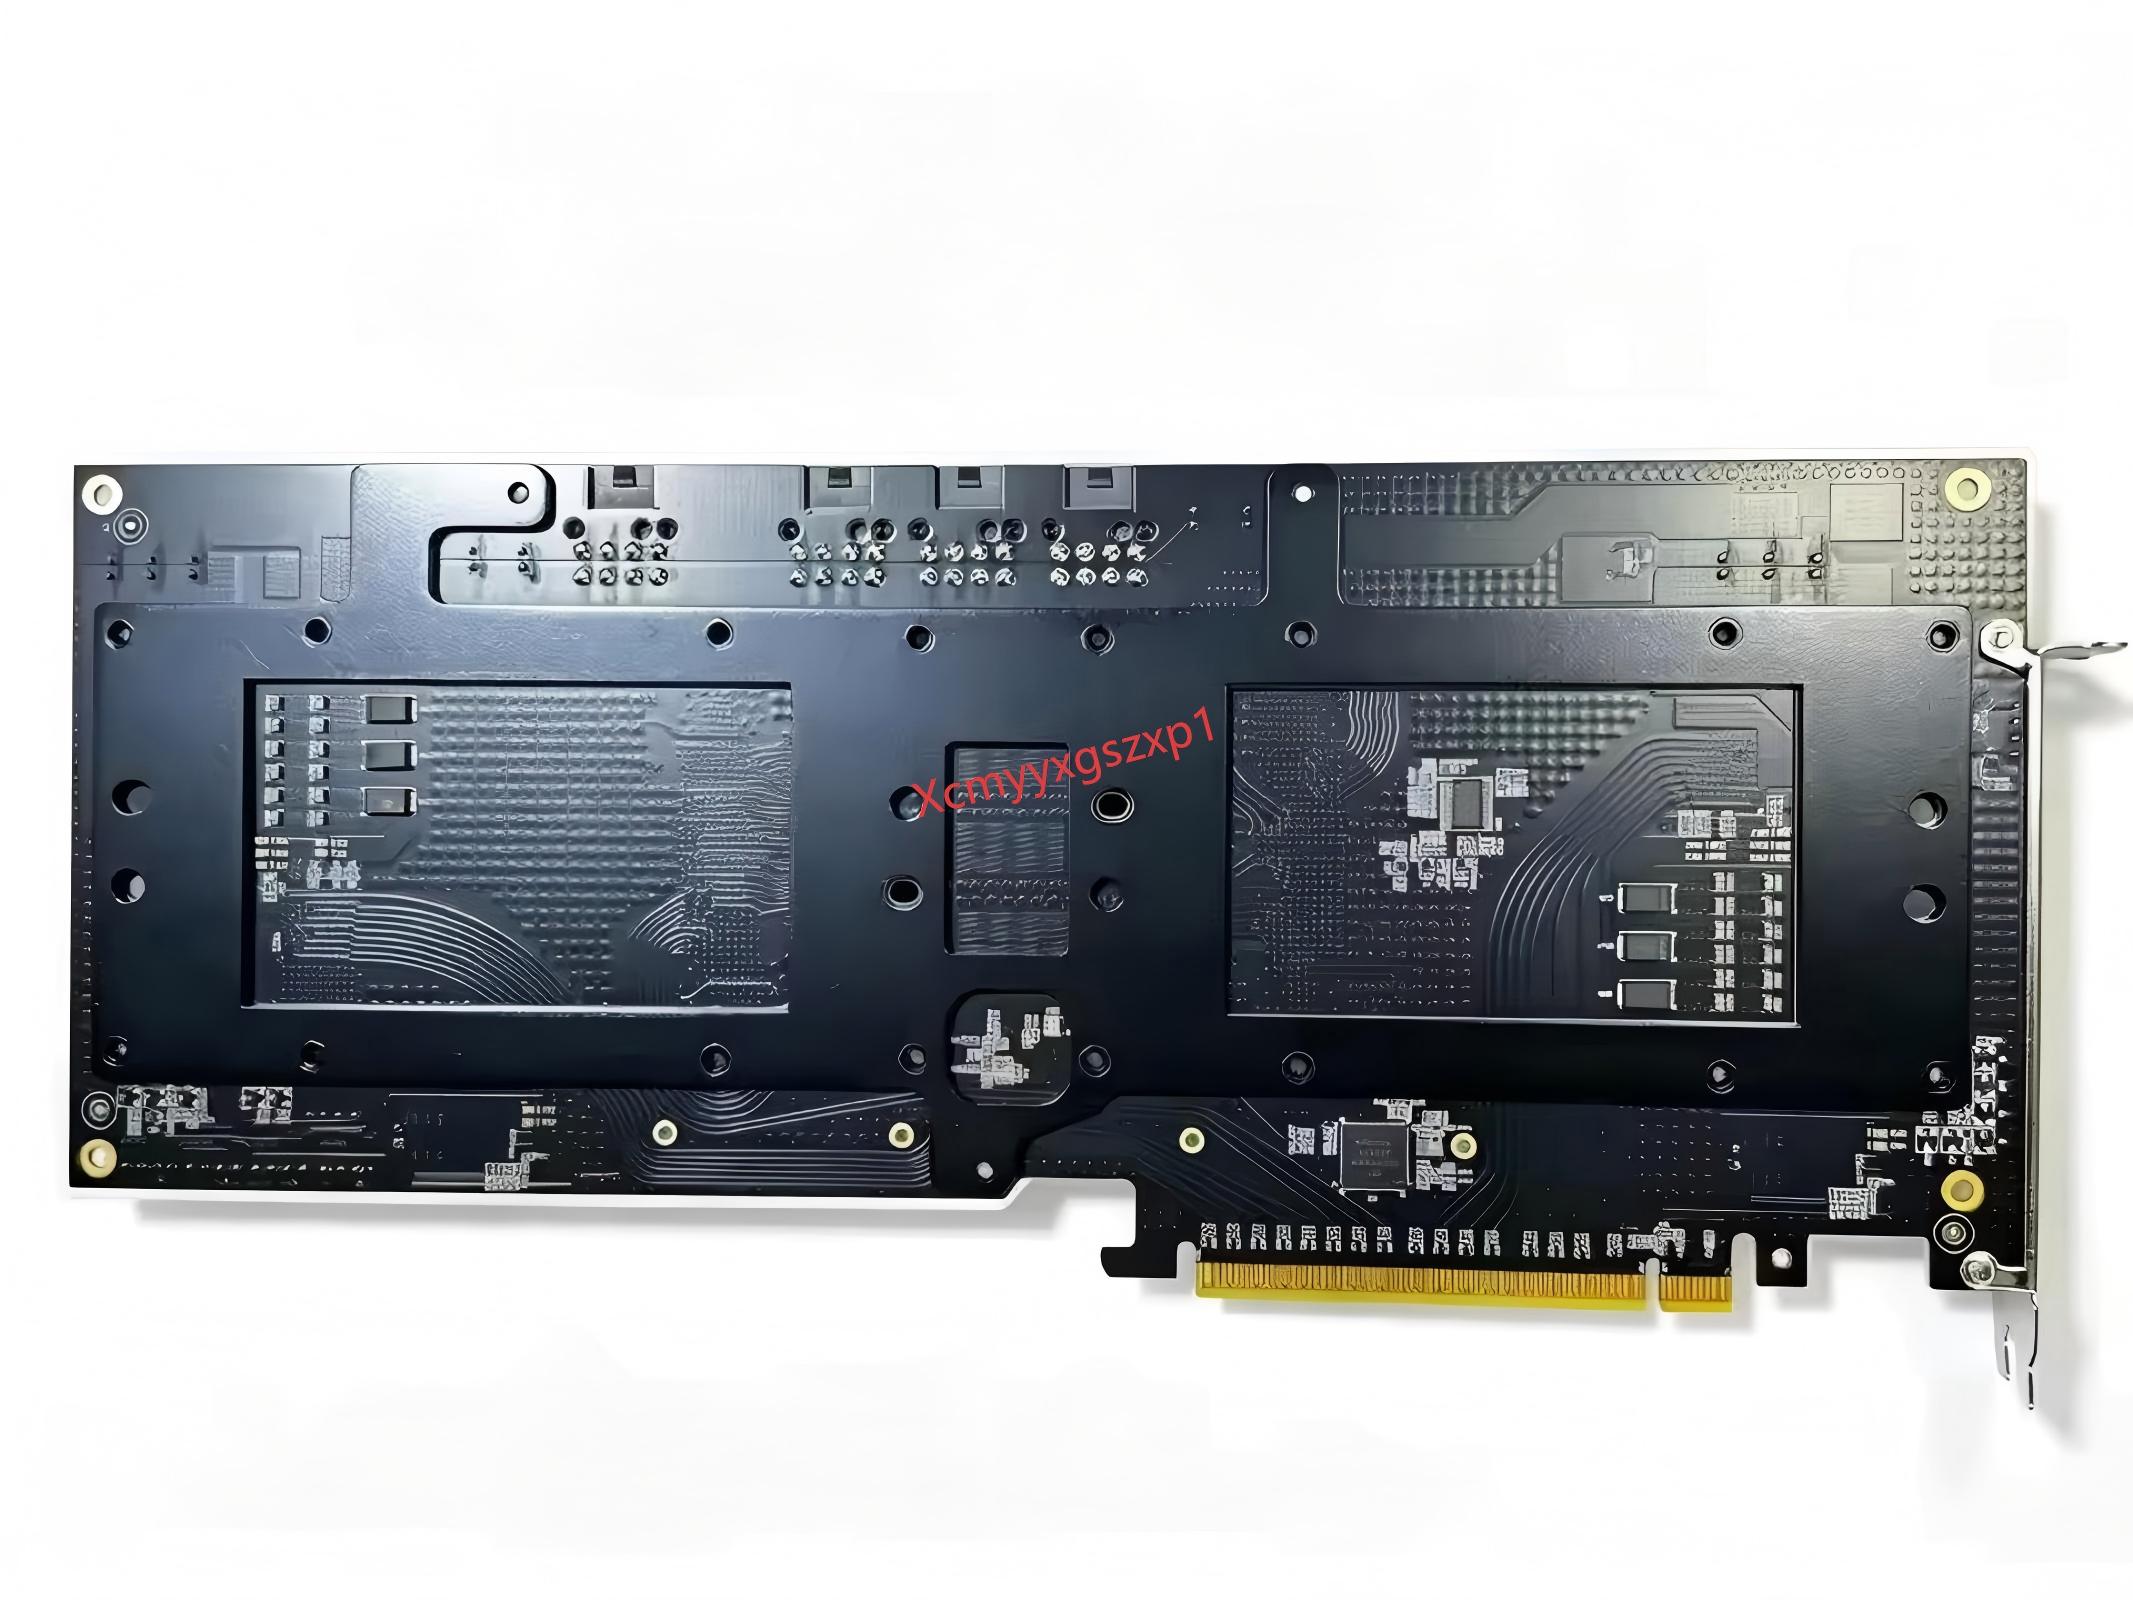
上部にはPCIe補助電源8-pinが4つ並んでおり、合計600Wの電力供給に対応。基板右下には冷却ファン用の4-pin PWM端子が4つ装備されています。さらに裏面全体を厚手の金属製スティフナー(バックプレート)が覆っており、重量級クーラーを取り付けても基板がたわまない堅牢な設計になっています。
なぜ今こんなカードが出回っているのか? — 米Summitスパコン解体と「大船到港」
「そもそも、なぜ今さら2017年登場のTesla V100なのか?」と疑問に思う方も多いでしょう。その背景には、国際的なスーパーコンピュータの世代交代劇があります。
米オークリッジ国立研究所で長年世界トップクラスの計算能力を誇っていたスーパーコンピュータ「Summit」が、2024年11月に退役・解体されました。このSummitには、実に約27,648枚の Tesla V100 SXM2 (32GB) が搭載されていました。
これら数万枚のV100モジュールが中古市場に一斉放出され、中国のハードウェア市場に格安で流入したのです(中国ギーク界隈で言う「大船到港(黒船来航)」)。
これにより、32GB HBM2メモリを搭載したモンスターチップが、1枚あたり1.5万〜2万円前後という冗談のような底値で取引される奇跡の相場が生まれました。

冷却はどうする? — A100 SXM4用純正ヒートシンク流用術と高静圧ファン
SXM2モジュールはサーバーラックの超強力なエアフローを前提としており、ヒートシンクもファンも付いていません。自作PC環境で冷やすための定番手法は以下の通りです。
① 最も安くて冷える「A100 SXM4 純正ヒートシンク」流用
コミュニティで最も推奨されているのが、AliExpressやTaobaoで数千円で転がっている「NVIDIA A100 SXM4 純正サーバーヒートシンク」の流用です。
A100とV100 SXM2はネジ穴ピッチが極めて近く、わずかなネジ穴の小加工(またはそのまま)でガッチリと固定できます。極太ヒートパイプと肉厚フィンを備えており、TDP 300Wを余裕で吸収します。
② 3Dプリントダクト + 80mm高静圧ファン(38mm厚が本命)
ヒートシンクに風を当てるため、Thingiverseで無料公開されているシュラウドを3Dプリントし、80mmの高静圧ファンを取り付けます。
ここで普通の静音PCファンを使うと風圧が足りず熱暴走します。サーバー用の38mm厚・10,000RPMファン(SilverStone FHS80Xなど)が本命です。静音性を重視する場合は5,000RPMのARCTIC P8 Maxを補助ファンとして活用します。


実測性能とベンチマーク — Qwen 32Bで50 tok/s、70Bモデルも64GBに丸載り
中国の1CATai公式検証ログおよびRex Yuan氏の実機テストデータによると、2枚のV100 SXM2(計64GB HBM2)をNVLink 300GB/s(Tensor Parallelism: TP=2)で稼働させた推論速度は以下の通りです。
| 評価モデル | 並列設定 | 実測デコード速度 | 体感・実用性 |
|---|---|---|---|
| Qwen / QwQ-32B | 単一ストリーム (TP=2) | 29.9 tokens/s | 思考モデルが人間の読書速度を余裕で超える |
| Qwen / QwQ-32B | 4並列ストリーム (TP=2) | 50.9 tokens/s | バッチ処理でも破綻せずスループット向上 |
| DeepSeek-R1-Distill-Llama-70B | 単一ストリーム (TP=2) | 12.7 tokens/s | 70B巨大モデルが実用的な対話速度で動作 |
| DeepSeek-R1-Distill-Llama-70B | 4並列ストリーム (TP=2) | 36.0 tokens/s | 高負荷時でもNVLink 300GB/sにより帯域飽和なし |
通常のPCIeマルチGPU環境では、GPU同士が通信する際にPCIeバス帯域(PCIe 3.0で約16GB/s)がボトルネックとなり、TP=2にすると性能が落ちることがあります。
しかし、本カードは300GB/sというPCIeの18倍の帯域で結ばれているため、GPU間通信のオーバーヘッドがほぼ消滅し、事実上の「巨大な単一64GB GPU」として振る舞います。
Voltaの壁を破る救世主「1Cat-vLLM」 — Make Volta Fast Again
「でもV100ってVolta(sm_70)だから、最新のFlashAttention-2/3が動かないのでは?」
これは自作AI勢なら誰もが突き当たる最大の懸念です。実際、本家vLLMの最新リリースではsm_70の最適化はほぼ放置されています。
この問題を解決するために中国コミュニティが立ち上げたのが、GitHubで公開されている専用フォーク「1Cat-vLLM」(github.com/1CatAI/1Cat-vLLM) です。
1Cat-vLLM: Make Volta Fast Again
Modern LLM inference for NVIDIA Tesla V100 / SM70
- ハンドチューンされたTurboMind SM70 CUDAカーネル: V100のTensorコアを極限まで駆動する専用カーネル(
awq_gemm_sm70)を搭載。 - AWQ 4-bit推論 & FP8 KVキャッシュ: V100でAWQモデルをフルスピード動作させ、KVキャッシュ圧縮により超長文コンテキストに対応。
- MoE高速化 & FP16オーバーフロー修正: Qwen 3.5/3.6/3.8 MoEやDeepSeekの推論時に発生するVolta固有のバグを完全解消。
このソフトウェアスタックの存在によって、2017年のGPUでありながら、2026年最新の大規模言語モデルを最前線でぶん回すことが可能になっています。
コスパ比較 — RTX 4090(35万円)やRTX 3090 2枚より圧倒的に優れている点
個人でローカルLLMを運用する際の主要なGPU選択肢と比較しました。
| 構成 | VRAM容量 | メモリ帯域 | GPU間帯域 | 70Bモデル | 概算総額 |
|---|---|---|---|---|---|
| 本カード + V100 32GB ×2 | 64 GB (HBM2) | 約1.8 TB/s | 300 GB/s | 〇(余裕) | 約10〜11万円 |
| GeForce RTX 4090 24GB | 24 GB (GDDR6X) | 約1.0 TB/s | なし | ×(載らない) | 約30〜35万円 |
| GeForce RTX 3090 24GB ×2 | 48 GB (GDDR6X) | 約1.8 TB/s | PCIe (16〜32GB/s) | △(帯域制限) | 約22〜25万円 (中古) |
| Mac Studio (M2 Ultra 64GB) | 64 GB (ユニファイド) | 800 GB/s | – | 〇 | 約35〜50万円 |
最大の強みは、「PCIeスロットを1本しか消費しない」という点です。
RTX 3090を2枚挿す場合、マザーボードのスロット間隔、排熱の干渉、巨大ケースの選定などハードルが跳ね上がります。本カードなら、1本のスロットに挿すだけで64GB VRAM環境が手に入ります。
おすすめ構成部品と自作環境の構築
本カードを安定運用するために不可欠な、実績のある推奨周辺パーツをまとめました。
① 電源ユニット(1000W ATX 3.1必須)
V100 SXM2は2枚で最大600Wを消費します。CPUやシステム全体の消費電力を考慮すると、1000W以上の電源が絶対条件です。また、PCIe 8-pinケーブルを分岐なしで独立4本取れるモデルを選んでください。


② オープンフレームケース & ライザーケーブル
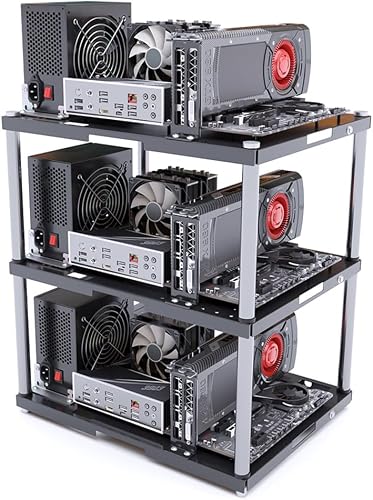
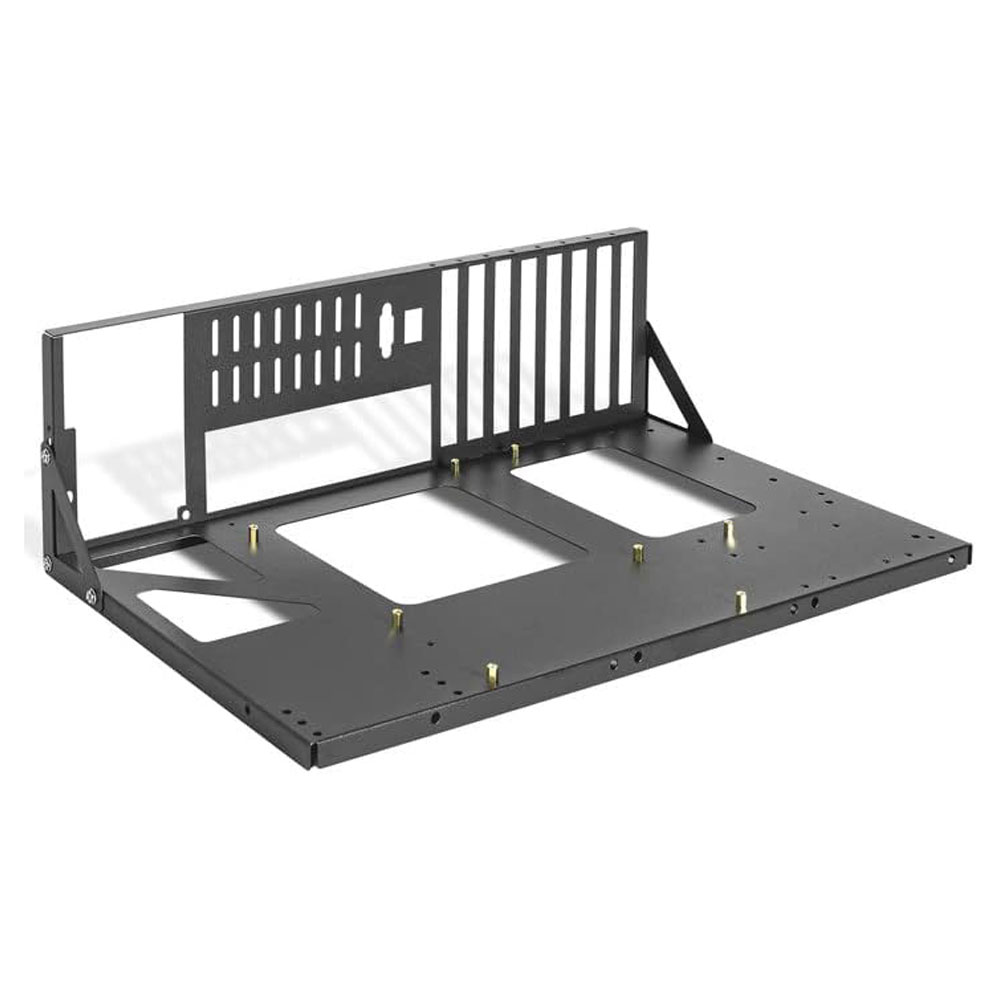
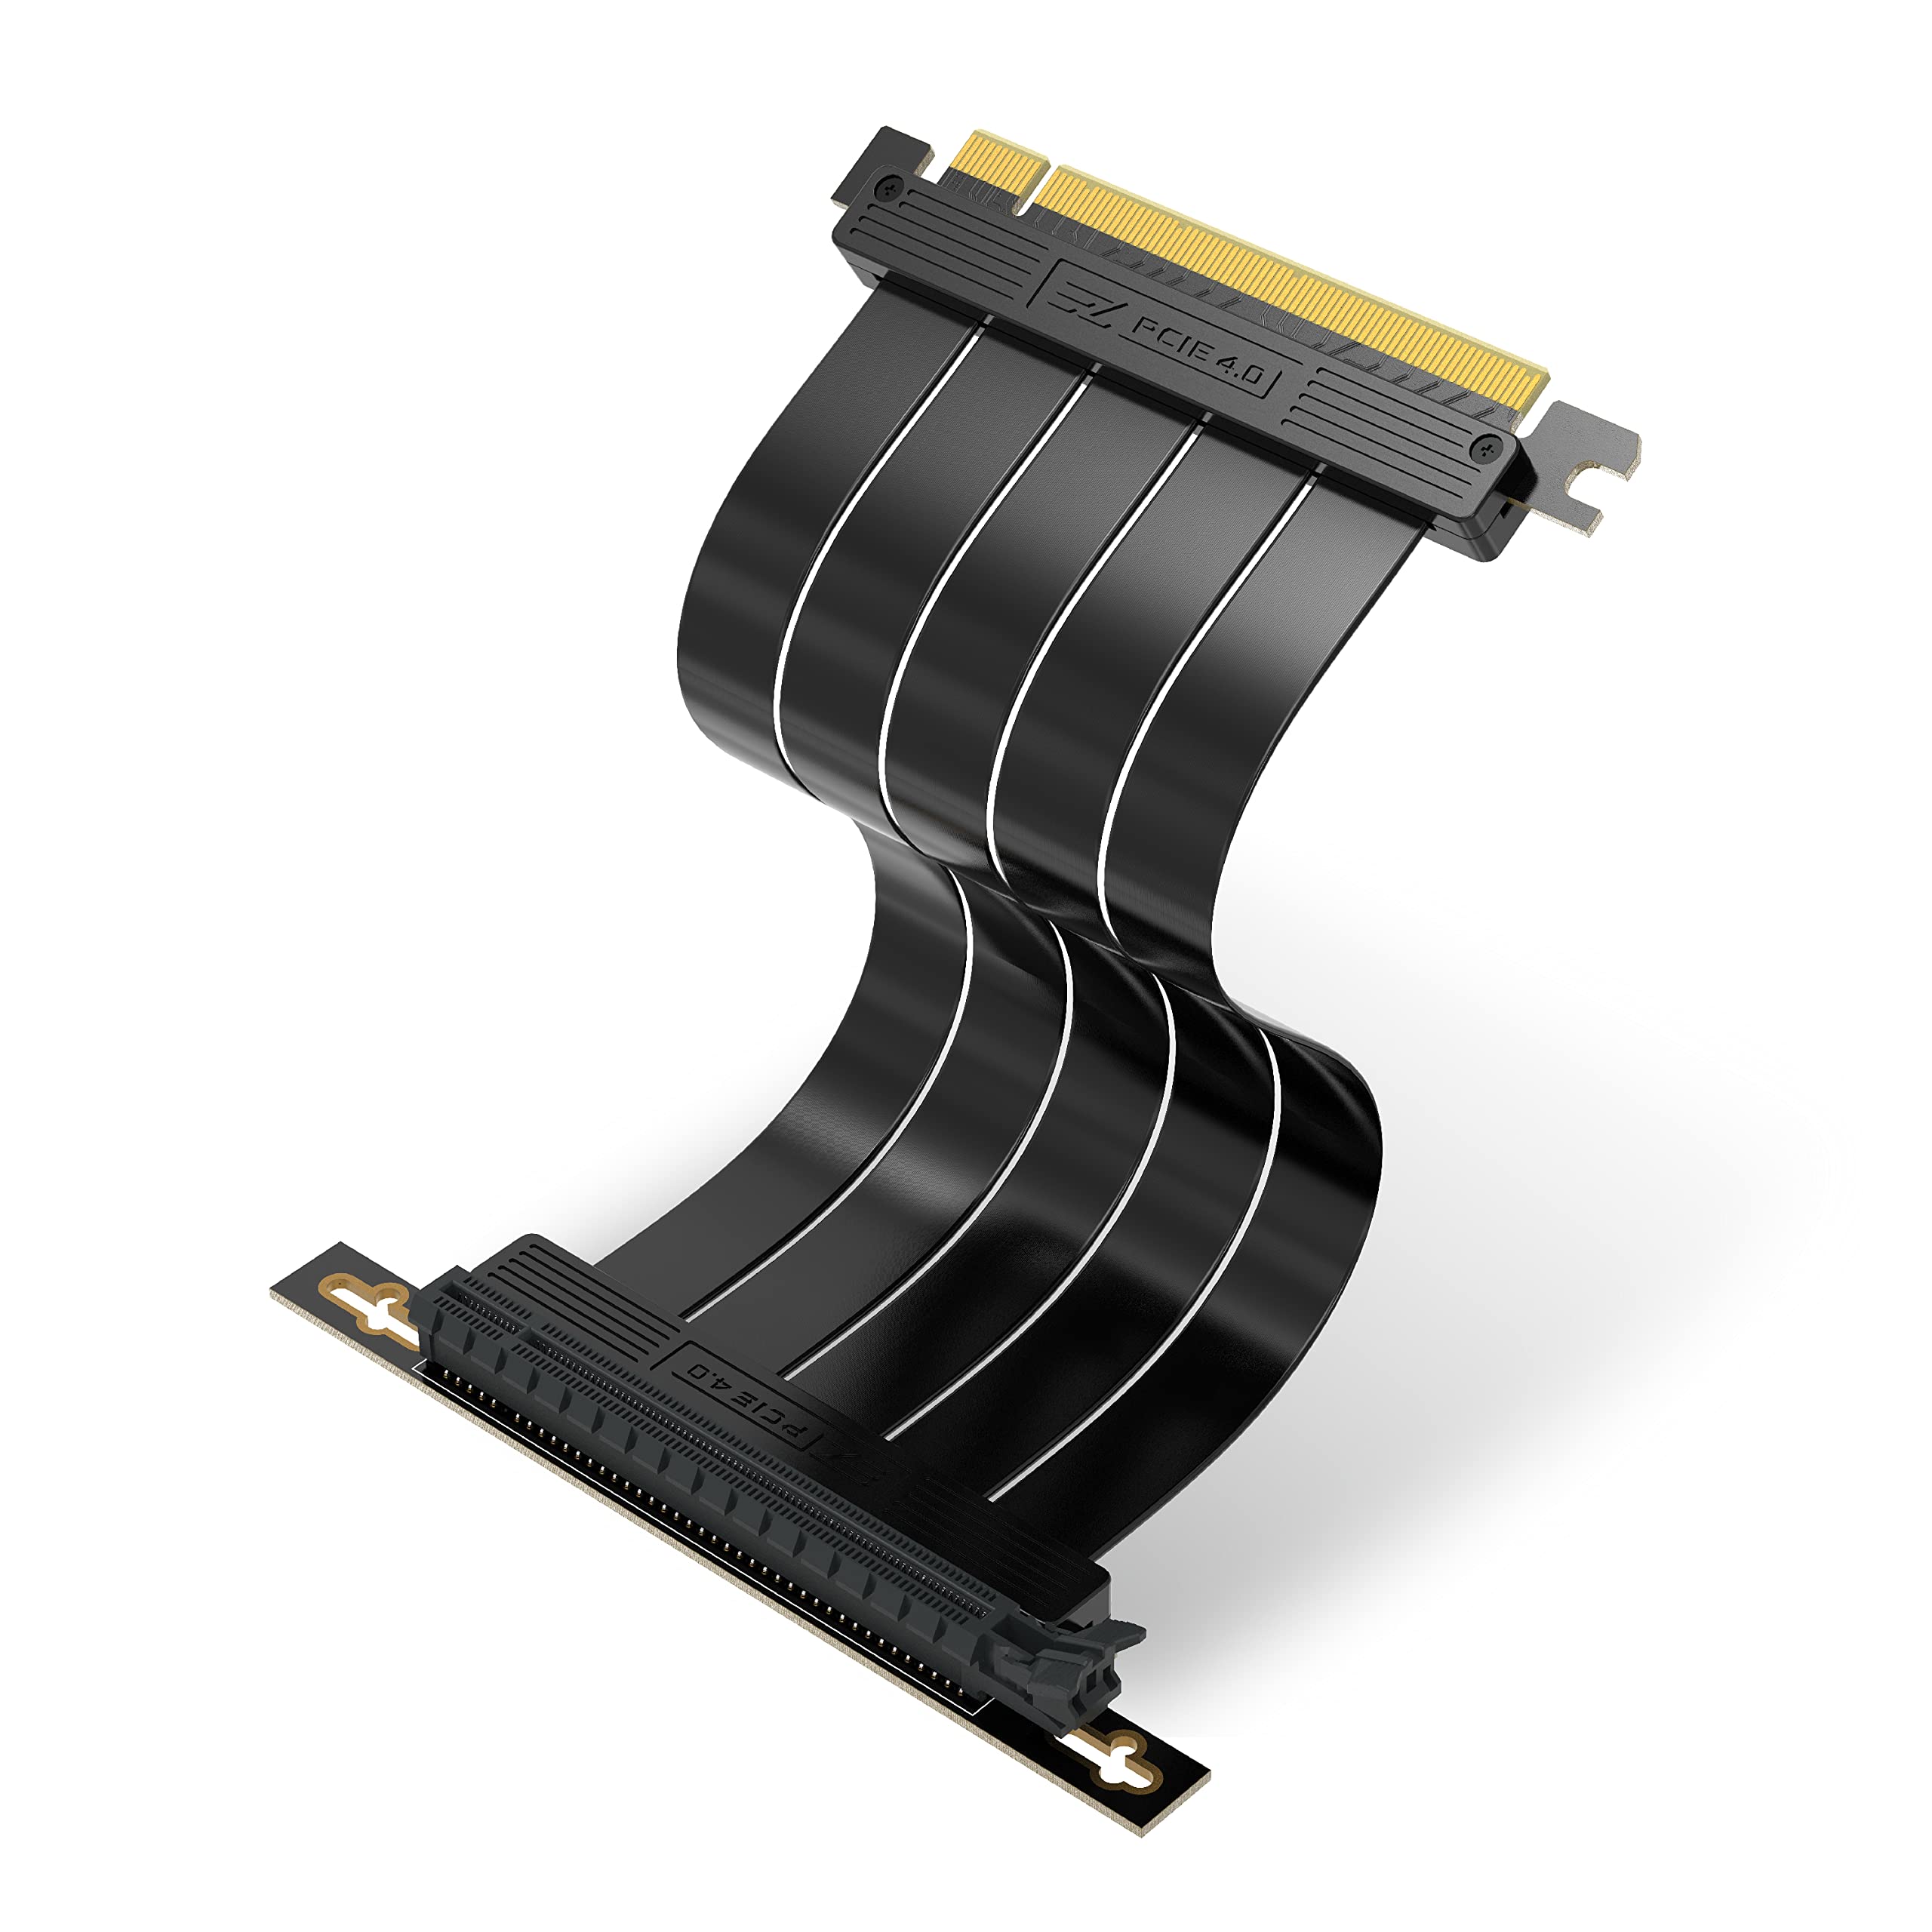
本カードはカード長が30cmを超え、厚みもヒートシンクとファンで3スロット分を占有します。密閉型ケースよりも、エアフローが完全に抜けるオープンフレームケースでの運用が圧倒的に扱いやすいです。また、垂直配置やマザーボードから離して設置する際はGen4対応の高品質ライザーケーブルを使用してください。

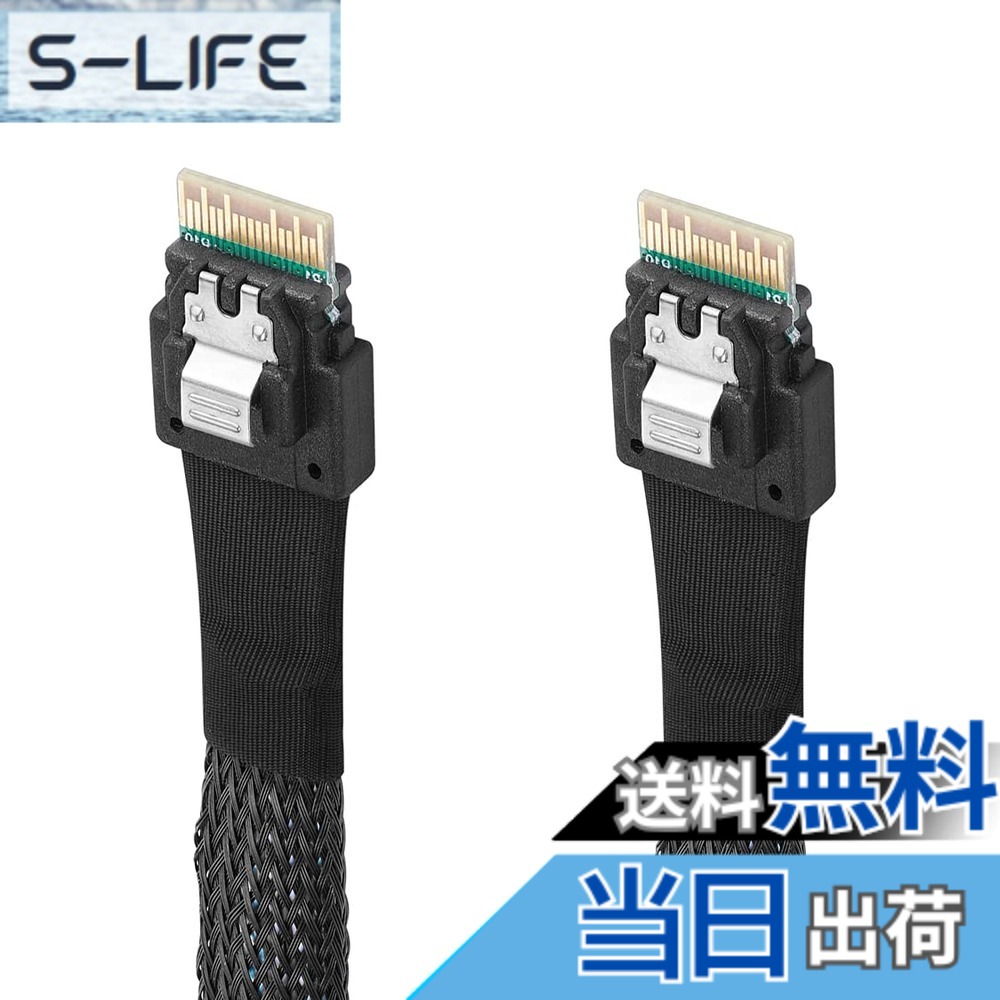
③ SFF-8654(SlimSAS)ケーブル(外付け・別基板タイプ用)
※本記事のAIC直挿し型基板では不要ですが、SlimSASポート経由で外付けケースに引き出すタイプの派生ボードを使う場合は以下のケーブルが必要です。

導入前のチェックリストと注意点 — Linux必須、映像出力なし、600Wの熱
購入ボタンを押す前に、以下の制約を必ず理解しておいてください。
- OSはLinux(Ubuntu 22.04 / 24.04)が原則必須:
Windowsでも認識自体は可能ですが、PLXスイッチ経由でのP2P NVLink通信や1Cat-vLLMの最適化カーネルはLinux環境が前提です。 - 画面出力端子(HDMI/DP)は存在しない:
サーバー用GPUのため画面出力はありません。CPU内蔵GPU(Intel UHDやRyzenのRDNA内蔵GPU)または画面出力用の安価なグラフィックボードが必要です。 - 合計600Wの爆熱:
冬場は最高の暖房になりますが、夏場はエアコンの効いた部屋での運用が必須です。ファンの風切り音も相当なものになります。
まとめ — 10万円で「64GB VRAM・NVLink」を手に入れるロマンと実用性
今回調査した「Tesla V100 SXM2 デュアルNVLinkアダプターボード」は、まさに中古エンタープライズパーツの旨味と、中国DIYハードウェアの技術力が極限で融合した奇跡のカードでした。
「70Bクラスの最新モデルをローカルで動かしたいけれど、RTX 4090を何枚も買う予算はない」「普通のデスクトップPCの1スロットで大容量VRAMを実現したい」というエンジニアやギークにとって、これ以上魅力的な選択肢は他にありません。
自作とLinuxの知識は必要ですが、それらを乗り越えた先には「約10万円で手に入る64GB HBM2の世界」が待っています。興味のある方はぜひチャレンジしてみてください!
主要パーツ購入リンク一覧
コメントを残す