▌ 実験ログ
【徹底検証】Tesla V100 SXM2を2枚載せる「デュアルNVLink基板」の正体:約10万円でVRAM 64GB・300GB/s環境は実用になるか?
AliExpressで流通する「Tesla V100 SXM2 デュアルGPU NVLink基板…
生成AI ラボ / Generative-AI Lab
次々と登場する生成AIを、実際に手元で動かして検証する研究ログ。モデルもツールもサービスも、ベンチマークから実用性まで——カタログ値や評判ではなく、自分で確かめた結果だけを記録していきます。
▌ 実験ログ
AliExpressで流通する「Tesla V100 SXM2 デュアルGPU NVLink基板…
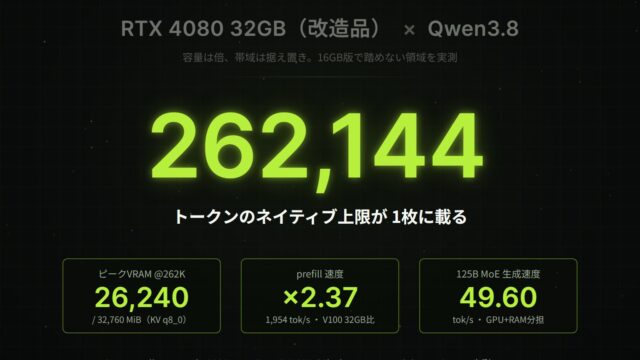
中国市場で流通するRTX 4080の32GB改造品を実機検証。Qwen3.8-27BのQ8_0が全層GPUに収まり22.47 tok/s、ネイティブ262,144トークンもKV q8_0により26,240MiBで動作。生成速度はTesla V100 32GBと同等ながらprefillは最大3.2倍。125B MoE(Qwen3.8-Flash-Next)のCPU併用やMiniMax H3動画生成、16GB/24GB制限時の挙動まで詳しく測定しました。
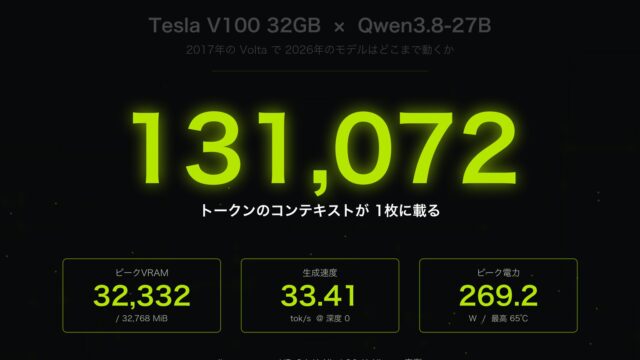
2017年のTesla V100 32GBでQwen3.8-27Bを実測。Q4_K_XLで33.41 tok/s、131,072トークンのコンテキストが25,264 MiBで1枚に載りました。KV量子化のCPUフォールバック、--reasoning-budget 1024が実用性を決める理由まで、実測データで検証します。
中古13万円のTesla V100 32GBでQwen 3.6を実測ベンチマーク。MoE 35Bは98.8 tok/sでM1 Maxの約1.6倍速。VRAM・電力・生成品質からllama.cppのVolta切り捨ての罠、コスパまで実測データで徹底検証します。
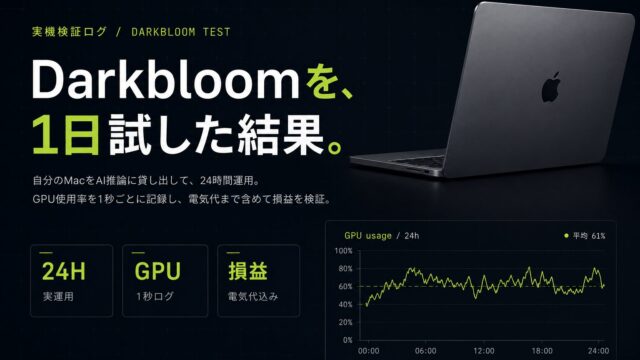
余ってるMacをDarkbloomのAI推論ノードとして貸し出すと本当に稼げるのか、MacBook Pro / M1 Max / 64GBで丸1日検証。公式試算は月75ドルですが、実測の24時間収益は0.60ドルで中身はほぼ基本報酬だけ。GPU使用率ログと実測電気代(0.36kWh/日)から損益まで正直に出しました。
前回の記事では、LLMに送るコンテキストを圧縮してAPI代を減らすツール「Headroom」を実測しました。あれから1週間ちょっと、今度は「肥大化したコード文脈をリアルタイム圧縮し…
前回は「トークン95%削減」を謳うHeadroomを実測しましたが、今回もGitHubで急騰中(公開約9日で700★超、The New Stackも特集)のADHDという、Clau…
前回はGTX 1080TiでQwenをどこまでローカルLLMとして動かせるかを検証しましたが、今回は新世代のQwen 3.6をApple M1 Max(64GBユニファイドメモリ)…
AIエージェントのトークン消費を最大95%削減すると謳うOSS「Headroom」を実際にMacへ導入し、ログ・JSON・コード・RAGの4種データで実測。コード79.8%・JSON59.2%・ログ31.0%削減、多段デバッグセッション全体では47.5%削減を確認しました。導入手順から仕組み、コスト試算、向き不向きまで正直にレビューします。
Apple M1 Pro(32GB)とM1 Max(64GB)で最新ローカルLLM「Qwen 2.5/3/3.5」をベンチマーク。MLX-LMとOllamaの速度比較、4bit/8bit量子化の違い、GTX 1080Tiとの三つ巴比較まで徹底検証。M1 Max + MLX 4bitでQwen 3.5 9Bが56.9 tok/sを記録しました。
GTX 1080Tiで最新の生成AI「Qwen 3.5 9B」がどこまで動くか検証しました。Q4_K_MとQ8_0の2つの量子化で速度・品質を比較。11GB VRAMの古いGPUでもローカルLLMは実用的に使えるのか、ベンチマーク結果を徹底解説します。
今回の記事では、Claude Code on Windows にて稀に作られる「nul」ファイルの削除方法について書いてみたいと思います。 Claude Code は非常に便利なツ…
これまでLevel 2からLevel 9まで、様々なアプリケーションを作ってきました。今回は集大成として、これまで学んだ技術を全て活用した「本格的なブログシステム」を構築します。 …