こんにちは、七宮さん(@shichinomiya_s)です。
前回はRTX 4080 32GB改造品の実力を測りましたが、今回はその続編です。前回のテーマは「VRAMが倍になると何が変わるか」でしたが、今回は演算性能そのものの話です。
2026年10月23日、Hugging FaceでAD103_win_unlockerというプロジェクトが公開されました。海外で「GPU unlock」と呼ばれている改造の、Windowsで使えるUEFI版です。対象は「32GBに改造された無印RTX 4080」、つまり筆者の手元にあるカードとまったく同じ種類です。GeForceには「FP16/BF16の行列演算をFP32で累積すると速度が半分になる」という制限がかかっていて、これをUEFI上で外してからWindowsを起動する、というツールです。作者の環境では、BF16の行列演算が約2倍になったと報告されています。
ただ、配布されているEFIは作者のPC 1台に合わせて作られていて、そのままでは筆者のPCでは動きませんでした。そこで、どこが違うのかを1つずつ確かめ、違いの部分だけをこのPCに合わせて移植し、実際にアンロックして性能を測りました。
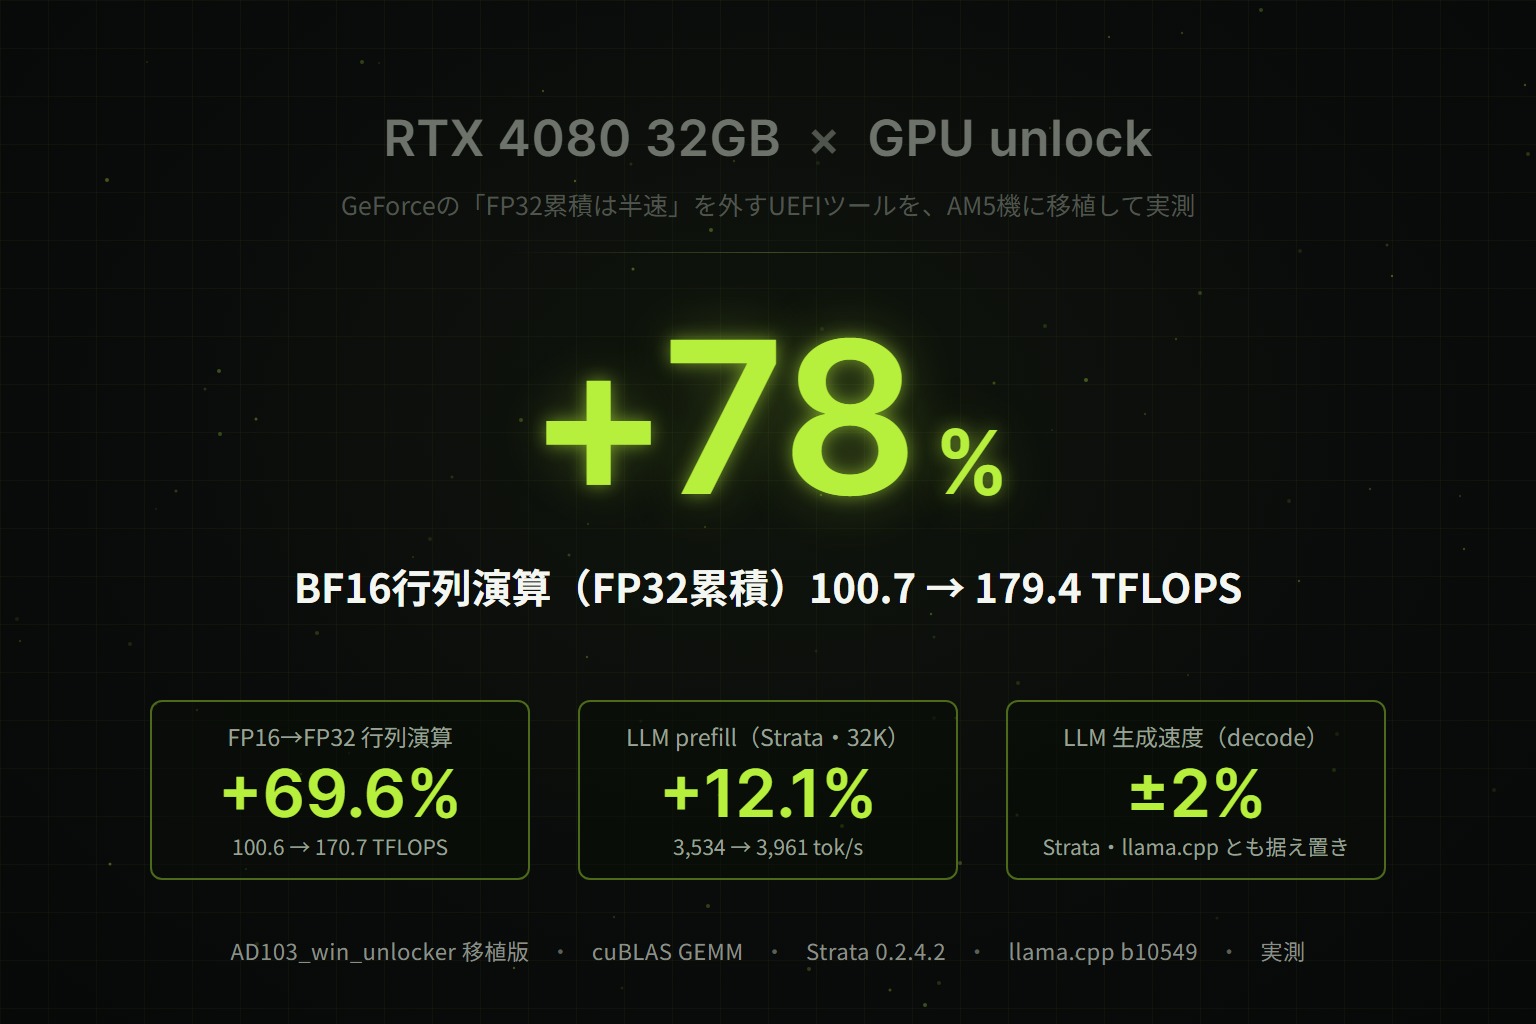
結論から言うと、行列演算そのものは最大+78%(BF16、100.71→179.42 TFLOPS)。TF32とFP8も+40〜63%速くなりました。計算結果は全57ケースで通常時とビット単位で一致しています。一方で、実際のアプリへの効き方はかなり限定的で、125B MoEのLLM(Strata)のprefillが+9〜12%、LLMの生成速度はほぼ変わらず、llama.cppの量子化モデルはほぼ0%でした。
数値はすべて自分で回した実測ログ由来です。途中で止まったところも含めて、そのまま書きます。
ご注意:この記事は、改造GPUに対して作者自身が「起動失敗・画面が映らなくなる・データ破損・ハードウェアの損傷が起こりうる」と明記している実験的なツールを使った記録です。メーカーの保証はもちろん、作者の保証もありません(AS IS)。試す場合は、すべて自己責任でお願いします。この記事で作った移植版のEFIは配布しません。
まず結論 — 実測サマリー
| 項目 | 通常(stock) | アンロック後 | 変化 |
|---|---|---|---|
| BF16→FP32 行列演算(N=4096) | 100.71 TFLOPS | 179.42 TFLOPS | +78.2% |
| FP16→FP32 行列演算(N=4096) | 100.61 TFLOPS | 170.66 TFLOPS | +69.6% |
| TF32→FP32 行列演算(N=8192) | 51.88 TFLOPS | 84.54 TFLOPS | +63.0% |
| FP8 E4M3→FP32 行列演算(N=4096) | 192.32 TFLOPS | 294.51 TFLOPS | +53.1% |
| FP32(CUDAコア)・FP16累積・INT8 | 変化なし | −1.1〜+2.7% | |
| Strata(125B MoE)prefill 32Kプロンプト | 3,534.0 tok/s | 3,961.2 tok/s | +12.1% |
| Strata 生成(チャット) | 143.3 tok/s | 144.6 tok/s | +0.9% |
| llama.cpp Qwen3.8-27B Q4_K_M 生成 | 35.85 tok/s | 35.87 tok/s | +0.1% |
| 計算結果(出力全体のSHA-256) | 全57ケースで一致 | — | |
一番大事な一行:速くなるのは「FP16/BF16/TF32/FP8を入力して、FP32で累積する行列演算」だけです。LLMのチャットの体感速度(生成速度)はメモリ帯域で決まるので、ほぼ変わりません。
「GPU unlock(SS unlock)」とは — GeForceの「FP32累積は半速」を外す
Tensorコアの行列演算には「何で入力して、何で足し合わせるか(累積)」の組み合わせがあります。たとえばFP16で入力してFP16のまま累積するか、FP16で入力してFP32で累積するか。後者のほうが誤差がたまりにくいので、PyTorchの混合精度学習や、多くの推論エンジンのBF16行列演算はFP32で累積する側を使います。
NVIDIAの公称値では、RTX 4080のFP16 Tensor性能は「FP16累積なら194.9 TFLOPS、FP32累積なら97.5 TFLOPS」。同じFP16入力でも、FP32で累積すると半分になります。プロ向けのRTX 6000 AdaやデータセンターのL40では、この制限はありません。つまり、ハードウェアとしてはできるのに、GeForceでは製品の区別として速度が抑えられている部分です。
この制限は、GPU内部の「SM speed-select」と呼ばれるセレクタのレジスタ(SS0 / SS1)で決まっていることがわかっていて、これを書き換えるのが「GPU unlock」です(レジスタ名から「SS unlock」とも呼ばれます)。系譜としては、LinuxカーネルモジュールでRTX 3090などを対象にしたZagitta/gpu-unlockがあり、これをAda世代(RTX 4090など)に広げたのがgpu-unlock-ada。今回のAD103_win_unlockerは、そのAda向けの処理(AD102用ペイロード)を作った作者によるWindows向けのUEFIアプリ版です。
仕組みをざっくり書くと、USBメモリから起動したEFIが次の順で動きます。
- カード・ROM・資産ファイルが想定どおりかを検査し、Windows Boot Managerを読み込んでおく(ここまでGPUには書き込まない)
- 画面に
READYが出たら、ユーザーがUキーを1回押す - GPUのUEFIドライバを切り離し、GPU内のセキュリティプロセッサ(SEC2)経由で、保護設定のレジスタ4つ(WPR_CFG / FBPA / WPR / FEAT)を書き換える
- SS0 / SS1を書き換え、PCIeのリセット(FLR)をかけて、画面を戻してWindowsを起動する
書き換えは永続しません。VBIOSは書き換えないので、作者の説明では、電源を切れば元に戻ります。効かせたいときは毎回USBから起動します。
| ツール | 動作環境 | RTX 4080(10de:2704) |
|---|---|---|
| gpu-unlock-ada | Linux(カーネルモジュール) | 対象外(RTX 4090 / 4070 Ti SUPER / 4060 Ti 16GB のみ) |
| AD103_win_unlocker | Windows(UEFIアプリ) | 対象(ただし作者のカード1枚・PC 1台に固定) |
作者自身は、結果としてFP16/BF16(FP32累積)の行列演算が N=4096 で約2倍、N=8192 で+60〜71%になったと報告しています。一方で「FP8やアプリでのLLMの高速化は主張しない」とも書いています。今回はそこまで測りました。
検証環境
| 項目 | 内容 |
|---|---|
| GPU | NVIDIA GeForce RTX 4080 32GB(改造品)/ PCI ID 10de:2704・Subsystem 10de:1795 / VBIOS 95.03.33.40.5E / 32,760 MiB / 電力上限 320W |
| ドライバ | 616.56 |
| CPU | AMD Ryzen 9 9950X(16コア32スレッド) |
| メモリ | DDR5-4800 32GB×2(64GB) |
| マザーボード | ASUS TUF GAMING X670E-PLUS WIFI(BIOS 3278) |
| OS | Windows 11 Pro(build 26200) |
| アンロック | AD103_win_unlocker(リビジョン 51df9c17、配布EFI v0.4.18)をこのPC向けに移植したもの |
| 行列演算ベンチ | 自作スクリプト(作者の bench.py と同じ手順を再現)/ PyTorch 2.11.0+cu128(cuBLAS / cuBLASLt)、Windowsネイティブ |
| LLM① | Strata 0.2.4.2(エンジン 0.1.48)+ Qwen3.8-Flash-Next IQ2_XS(125B MoE、約64GB) |
| LLM② | llama.cpp b10549 + Qwen3.8-27B系 Q4_K_M / Q5_K_M |
比較の基準は、アンロックの直前に同じ表示構成(後述のとおり内蔵GPUを無効にして、RTX 4080で画面を出す構成)で測った通常時(stock)の値です。stockとアンロック後で、スクリプト・順番・開いているアプリをそろえています。
使ったのは前回の記事と同じカードです。
配布版のままでは動かない — 作者の環境との違いを洗い出す
READMEには「このEFIは 10de:2704 / 10de:1795 と特定のROMハッシュに固定してある。同じ製品名の別のカードは拒否されることがある」と書かれています。ソースを読むと、実際にはカードだけでなく作者のPC(マザーボード)の値まで固定されていました。まずは手元の環境と1つずつ突き合わせました。
| チェック項目 | 作者の環境 | 筆者の環境 | 判定 |
|---|---|---|---|
| PCI ID / Subsystem | 10de:2704 / 10de:1795 | 同じ | ✅ |
| VRAM / 電力上限 | 32,760 MiB / 320W | 同じ | ✅ |
| ROM本体のハッシュ | 603baffe… | 同じ(ファイル全体のハッシュは違う) | ✅ |
| Secure Boot | 無効 | 無効 | ✅ |
| 画面を出すGPU | RTX 4080のみ(内蔵GPUなし) | CPU内蔵のRadeonで表示 | ⚠️ BIOS設定で対応 |
| BAR0のアドレス | 0x80000000 | 0xF5000000 | ❌ |
| SS1のコールド値 | 7 | 5 | ❌(後で判明) |
ROMは「本体部分」が一致
まずGPU-Z 2.71.0でVBIOSを保存し、リポジトリに入っている check_rom.py で照合しました。結果は NOT MATCHED。ただ、中身を調べると、ファイル全体(2MB)のうち、先頭のヘッダ部分と後半の領域が違うだけで、EFIが実際に照合するROM本体の部分(879,616バイト)のハッシュは作者のものと完全に一致していました。同じVBIOS(95.03.33.40.5E)で、ファイルの差は個体ごとのデータと考えられます。後のドライランでは、GPUが実際に読むROMの窓(1MiB分)のハッシュも、作者の記録と一致しました。
なお、保存したROMには個体ごとのデータが含まれるので、公開はしません。
BIOSで内蔵GPUを無効にする
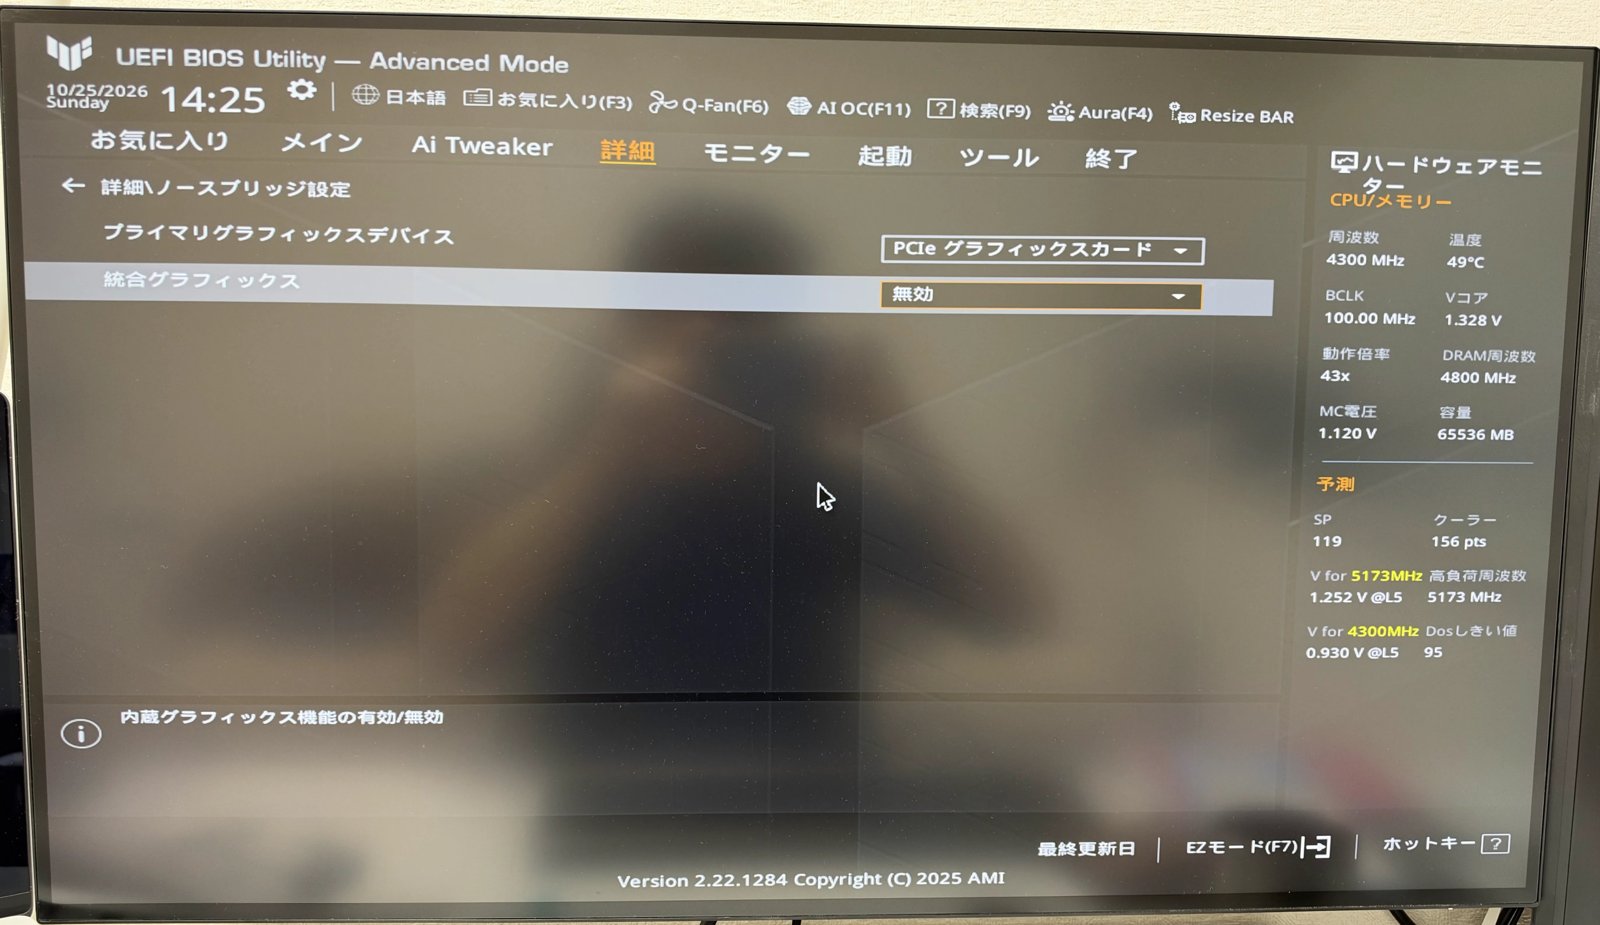
EFIは「UEFIの画面出力(GOP)がちょうど1つで、それがRTX 4080であること」を要求します。筆者はふだんCPU内蔵のRadeonで画面を出しているので、BIOSで内蔵GPUを無効にし、モニターのケーブルをRTX 4080に挿し替えました。
ドライラン① 配布版EFI — BAR0のチェックで止まる
いきなり本番はやらず、まずはGPUに何も書き込まない段階で止まることを確かめるドライランです。EFIのソースを読んで、READYが出てUキーを押すまでは、PCIの設定やレジスタを読むだけでGPUへの書き込みがないこと、途中のチェックで止まった場合はレポートを書いてファームウェアに戻るだけなことを確認してから、USBメモリ(FAT32)に配布版のEFIと資産ファイルを入れて起動しました。
資産ファイルとは、NVIDIAのLinux向けドライバ 610.43.03 から取り出すGSPファームウェアなどです。NVIDIAのファイルなので配布はされておらず、付属の prepare_assets.py をWSL2で実行して、手元でハッシュを照合しながら作ります(筆者の環境では zstd の追加と、Git LFSのファイル取得が必要でした)。
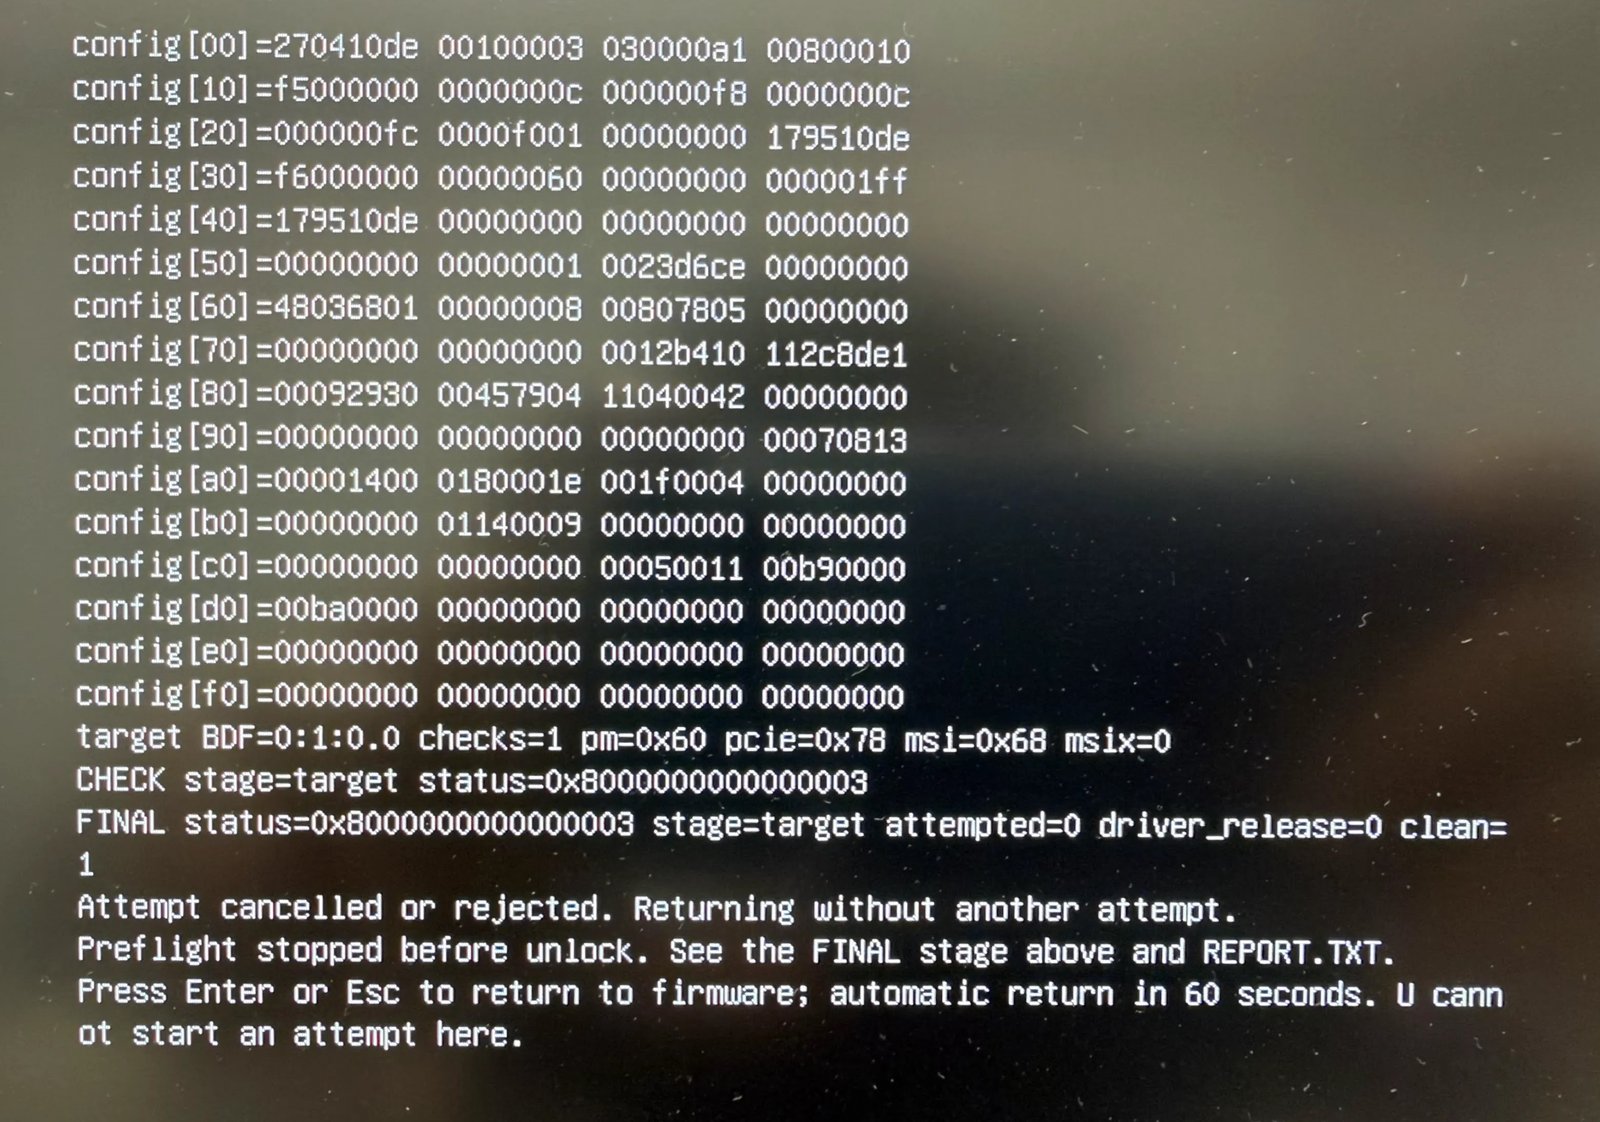
config[10]=f5000000 がBAR0。作者の環境の 80000000 と違うため、最初のチェックで止まりましたCHECK stage=target status=0x8000000000000003
FINAL status=0x8000000000000003 stage=target attempted=0 driver_release=0 clean=1
Preflight stopped before unlock. See the FINAL stage above and REPORT.TXT.attempted=0 driver_release=0 は「GPUには何もしていない」という意味です。カードのID・Subsystem・クラス・ケーパビリティなどの条件はすべて通っていて、不一致はBAR0の1つだけでした。
BAR0は、GPUのレジスタがメモリ空間のどこに見えるかというアドレスで、カードではなくマザーボードのBIOSが起動時に割り当てる値です。このPCの32ビットのMMIO領域は 0x80000000〜0xF6FFFFFF で、作者の値(領域の先頭)もこの範囲には入っています。ただ、ASUSのBIOSは上から順に割り当てるようで、BAR0は上端付近に置かれます。内蔵GPUを無効にしたら、その分だけ 0xF4000000 → 0xF5000000 と上にずれたのもこの見方と合います。割り当て方を変えるBIOSの項目は見当たらず、配布版のままこのチェックを通すのは、このマザーボードでは無理そうでした。
移植① BAR0の定数をこのPCの値に — ソースの差は3行
ソースで 0x80000000 を探すと、固定値を使っているのは実行前のチェックの3行だけで、実際の処理はUEFIから受け取った実際のBAR0を使って動く作りでした。そこで、この3行だけをこのPCの値に変えてビルドし直します。
ビルドの前に、手元のツールチェーンで作者と同じバイナリが作れるかを確かめました。Zig 0.14.1(公式のハッシュと一致を確認)で、何も変えていないソースをビルドすると、SHA-256が 9f821b8e…338eb01 で配布版のEFIとバイト単位で完全に一致。これで、「同じ手順で、数行だけ違うソースからビルドした」と言える状態になりました。
| 場所 | 配布版 | 移植版 |
|---|---|---|
unlock/app.c:74(PCIコンフィグのBAR0) | ==0x80000000 | ==0xf5000000 |
unlock/app.c:160(BAR0の範囲の先頭) | !=0x80000000 | !=0xf5000000 |
unlock/app.c:163(BAR0の範囲の末尾) | !=0x80ffffff | !=0xf5ffffff |
カード側のチェック(ID、Subsystem、チップ、ROMのハッシュ、VRAM、コールド状態、資産のハッシュなど)には一切手を付けていません。
ドライラン② SS1の値がチップごとに違った
移植版で起動すると、BAR0のチェックは通り、画面出力・ドライバの所有権・チップIDのチェックも通過。次の「コールド状態」のチェックで止まりました。
cold state: chip=0x193000a1 plm=0xffffff8f gfw=0x8b8f/0x3ff/0x10 WPR2_HI=0 SS0=0x4240021 SS1=0x5
CHECK stage=cold-state status=0x8000000000000006
FINAL status=0x8000000000000006 stage=cold-state attempted=0 driver_release=0 clean=1EFIは「SS1が7であること」を要求していますが、このカードは5。ほかの条件(まだアンロックされていないこと、保護設定が初期状態であることなど)はすべて満たしています。公開されている記録から、各カードのSS0 / SS1の初期値を並べてみました。
| カード | ダイ | SS0(初期値) | SS1 | 結果 |
|---|---|---|---|---|
| 作者のRTX 4080 32GB | AD103 | 0x31322012 | 7 | 成功 |
| RTX 4070 Ti SUPER | AD103 | 0x06301153 | 6 | Linux版で成功 |
| RTX 4090 | AD102 | 0x44023025 | 7 | 成功 |
| RTX 4060 Ti 16GB | AD106 | 0x01403041 | 3 | 成功 |
| MSI RTX 4070 Ti | AD104 | 0x23617005 | 1 | Windows移植版で成功 |
| 筆者のRTX 4080 32GB | AD103 | 0x04240021 | 5 | — |
同じAD103どうし、それどころか同じVBIOSの同じ製品でも初期値が違うので、チップごとに焼き込まれた値(ヒューズ)から決まると考えられます。アンロック後はどのカードもSS0=0x88888888、SS1=0x8 にそろいます。Linux版は同じ書き換え処理でSS1=6・3・1のカードを通しているので、「SS1=7」は処理の前提条件ではなく、作者のカードと同じ個体かを見るための固定値と判断しました。Uを押した後の処理にSS1=7を前提にした条件がないこともソースで確認し、この1行もこのカードの値(5)に変えた移植版v2を作りました。
ドライラン③ READY到達 — ここでは Esc
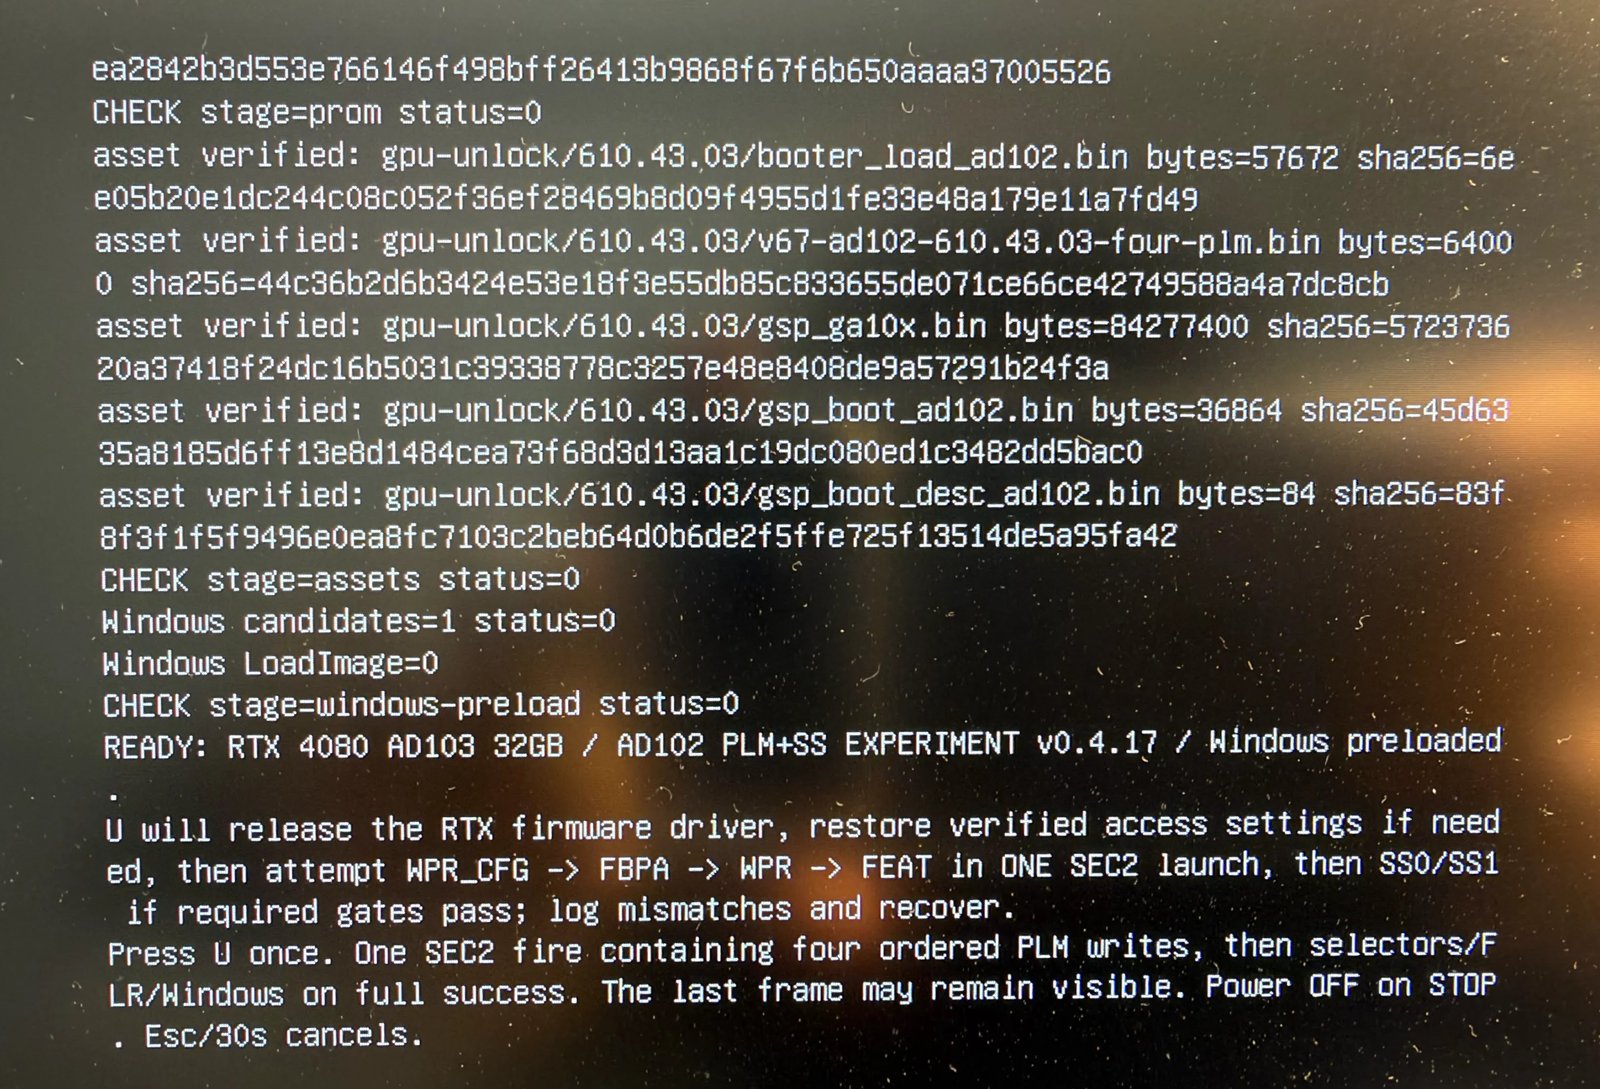
READY 画面。ここで U を押すと本番、Esc で中止です移植版v2で、Uキーを押す直前のチェックをすべて通過しました。この回はEscで中止して、レポートを回収しています。ここで、GPUが実際に読むROMの窓(1MiB)全体のハッシュが、作者の記録した値と完全に一致しました。作者のカードとの違いとして確認できたのは、マザーボード側のBAR0の位置とチップ個体のSS0 / SS1の初期値の2点だけ、ということになります。
なお、毎回の再起動後、USBメモリがWindowsで「不明なUSBデバイス」になり、抜き差しすると認識される、ということが続きました。レポートの回収はこの手順で行っています。
本番 — Uを1回押して、アンロック成功
念のため、アンロックの前に通常時(stock)のベンチマークを一式取ってから本番に進みました。完全に電源を切ってから起動し、F8でUSBを選んで、READY でUを1回。少し待つとWindowsが普通に起動しました。画面もRTX 4080で正常に映り、nvidia-smi も32,760 MiBのカードとして認識しています。レポートの要点はこうです。
AD102 PLM final: WPR_CFG=0xfffff0ff matched=1 / FBPA=0xffffff0f matched=0 / WPR=0xffffffff matched=1 / FEAT=0xffffffff matched=1
SELECTOR RESULT: SS0 before=0x5240021 after=0x88888888 expected=0x88888888 matched=1 status=0
SELECTOR RESULT: SS1 before=0x5 after=0x8 expected=0x8 matched=1 status=0
transaction result=0 containment=0 started=1 quiesced=1 fault=0 retained=0 maps=0 FLR=1
POST-FLR SS0=0x88888888 SS1=0x00000008
POST-GOP SS0=0x88888888 SS1=0x00000008
FINAL status=0 stage=post-unlock-handoff attempted=1 driver_release=1 clean=1
SS0 / SS1はどちらも狙いどおりの値になり、PCIeリセット(FLR)後も画面の再接続後も保たれています。保護設定4つのうちFBPAだけ要求値にならないのは、作者の成功例と同じです(作者も「致命的ではない」と扱っています)。
1つ面白かったのは、SS0の初期値がドライランのとき(0x04240021)と本番(0x05240021)で違っていたことです。上から2桁目が4→5に変わっていて、起動のたびに少し変わる値なのかもしれません。EFIはSS0の「書き換え済みのビット」が立っていないことしか見ていないので、判定には影響しませんでした。
検証結果① 行列演算 — FP32で累積する演算だけが速くなる
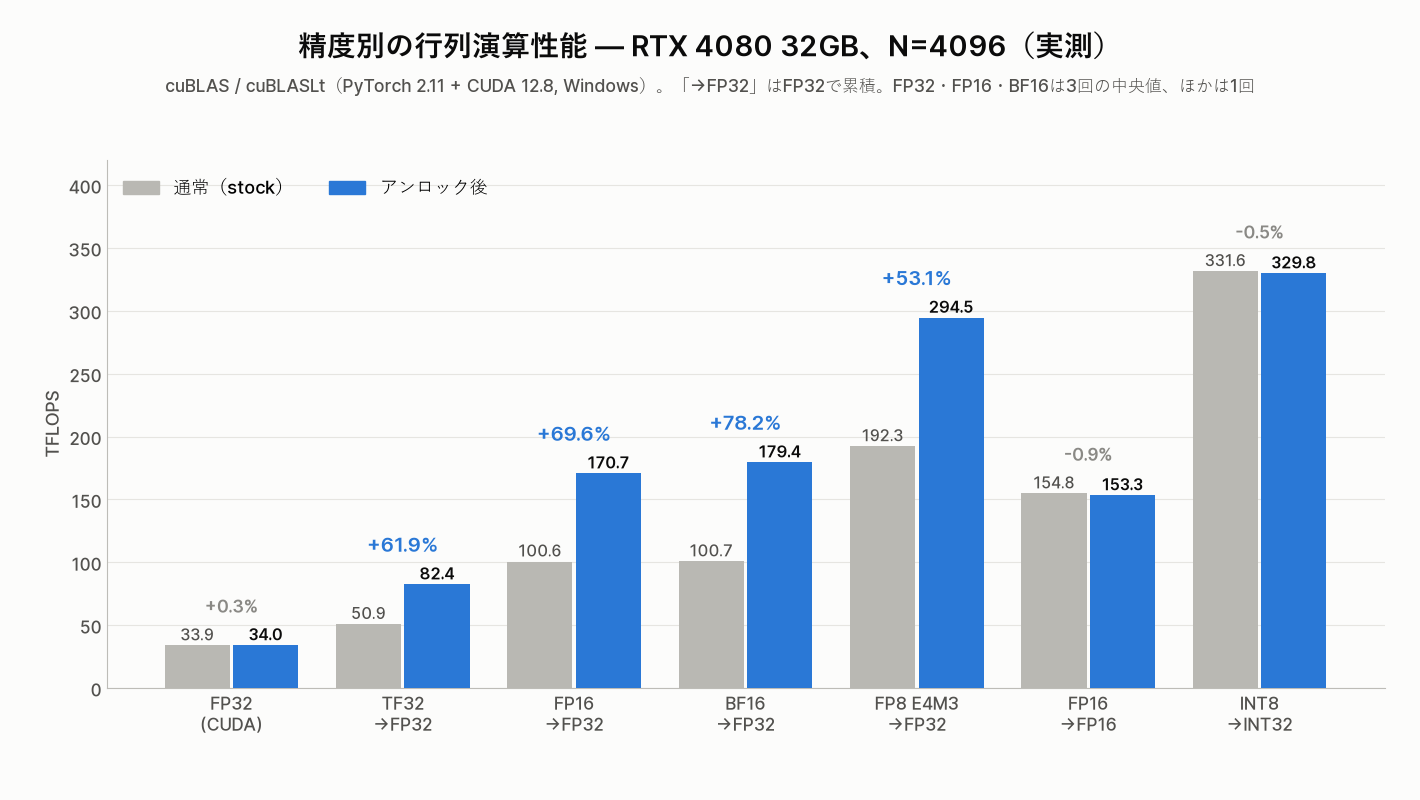
| 精度 | N=4096 | N=8192 | N=16384 |
|---|---|---|---|
| FP32(CUDAコア) | 33.88 → 33.98(+0.3%) | 33.08 → 33.26(+0.5%) | — |
| FP16→FP32 | 100.61 → 170.66(+69.6%) | 100.56 → 155.93(+55.1%) | 104.18 → 165.91(+59.3%) |
| BF16→FP32 | 100.71 → 179.42(+78.2%) | 102.37 → 166.16(+62.3%) | 104.73 → 175.89(+67.9%) |
| TF32→FP32 | 50.89 → 82.39(+61.9%) | 51.88 → 84.54(+63.0%) | — |
| FP8 E4M3→FP32(cuBLASLt) | 192.32 → 294.51(+53.1%) | 200.31 → 286.46(+43.0%) | 199.40 → 281.05(+40.9%) |
| FP16→FP16(もともと全速) | 154.77 → 153.30(−0.9%) | 147.48 → 151.40(+2.7%) | 171.17 → 172.66(+0.9%) |
| INT8→INT32(もともと全速) | 331.57 → 329.81(−0.5%) | 362.37 → 367.08(+1.3%) | 373.01 → 368.94(−1.1%) |
(単位はTFLOPS。FP32・FP16→FP32・BF16→FP32のN=4096 / 8192は作者と同じ手順での3回の中央値、それ以外はスイープ1回の値)
理屈どおり、FP32で累積する演算だけが大きく伸びて、もともと全速のFP16累積やINT8、CUDAコアのFP32は変わりません。もともと全速の演算が1〜3%の範囲で前後しているのは、計測のぶれと見てよさそうです。
作者が触れていなかったところでは、TF32とFP8(FP32累積)も+40〜63%速くなりました。gpu-unlock-adaのRTX 4070 Ti SUPERの報告では、FP8のCUTLASSカーネルは変化なし(59.3→59.5 TF)だったので、ここは食い違います。今回はcuBLASLt(PyTorchの torch._scaled_mm)での計測で、カーネルの違いが原因かどうかは確かめていません。
LLMの重みの形に合わせた長方形の行列(トークン数512〜8192 × 5120↔17408)でも、FP16/BF16(FP32累積)は+30〜72%でした。
そして重要なのが、計算結果がまったく変わっていないことです。全57ケースで、出力全体のSHA-256がstockとアンロック後で一致しました。同じカーネルが同じ答えを、速く出しているだけです。あわせて、FP64で計算した参照値との検算も全ケースで通っています。
作者の値(WSL2で計測)と比べると、こちらの通常時はFP16/BF16で3〜10%高めに出ています(たとえばBF16 N=4096で作者91.91、こちら100.71)。Windowsネイティブで測っていることや、cuBLASのバージョンの違いが考えられますが、確かめてはいません。比較は必ず同じ環境のstockとアンロック後で行っています。
検証結果② 大きい行列ほど伸びが鈍る — 320Wの電力の壁
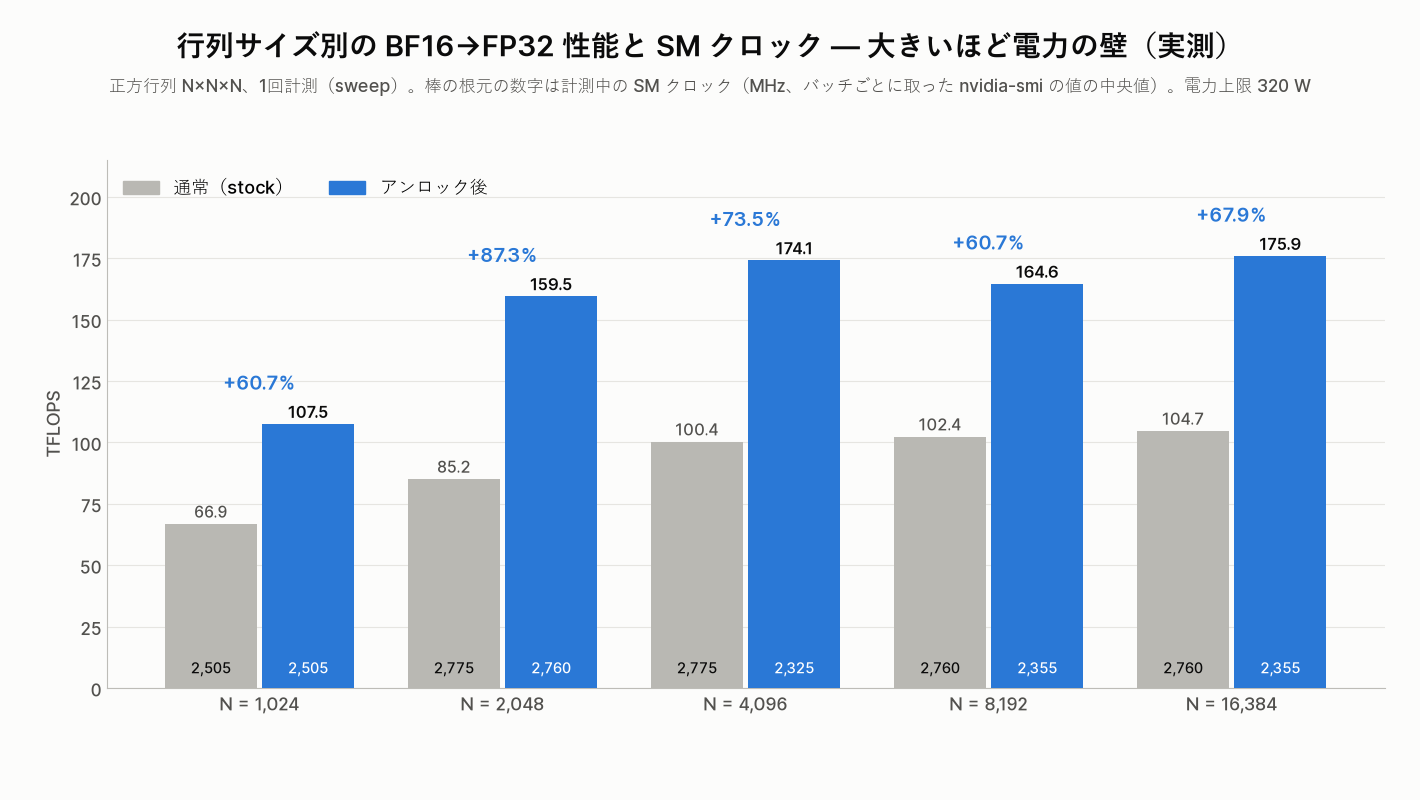
理論上はFP32累積の演算が2倍の速さになるはずですが、実測はN=4096以上で+53〜78%。届かない理由は電力です。行列演算中のクロックを見ると、N=8192のとき、stockではSMクロックが2,730〜2,790MHzなのに対し、アンロック後は2,160〜2,355MHzまで下がっていました。nvidia-smiの制限理由は「SW Power Cap」。演算器は倍の速さで回れても、320Wの電力上限に当たってクロックが下がるので、そのぶん伸びが削られます。
N=1024〜2048のように電力に余裕がある小さい行列では、クロックはstockとほぼ同じのまま+60〜87%伸びています。作者のN=8192(+60〜71%)や、RTX 4070 Tiの報告(アンロック後に2,940→2,565MHz)も同じ傾向です。ちなみにNVIDIAの公称値で全速時のFP16(FP32累積)は194.9 TFLOPSなので、今回の最大179.42 TFLOPSはその92%に当たります。
検証結果③ 実アプリ — LLMのprefillは+9〜12%、生成は変わらない
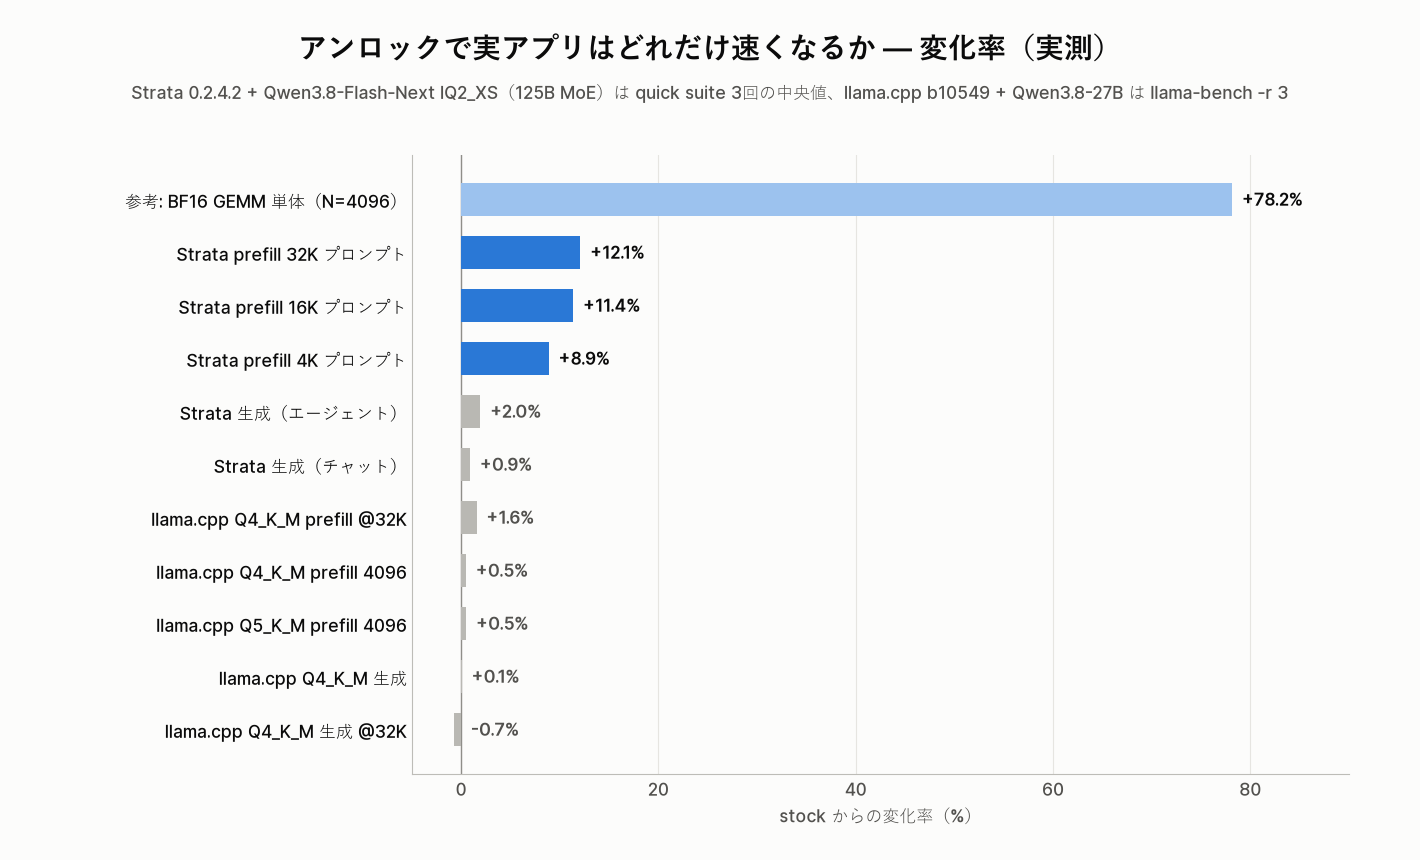
行列演算が+70%になっても、アプリ全体がそのまま+70%になるわけではありません。どの演算をどれだけ使っているかで、効き方がはっきり分かれました。
Strata(125B MoE)— prefillが+9〜12%
Strataは、VRAMに収まらないMoEモデルを、VRAMとメインメモリに分けて動かすローカル推論エンジンです。ソースを見ると、prefill(プロンプトの読み込み)の行列演算はcuBLASのBF16/FP16入力・FP32累積(cublasGemmEx の CUBLAS_COMPUTE_32F)で、まさにアンロックで速くなる演算です。いちばん効果が出そうだと見込んで選びました。
| 指標(tok/s) | stock | アンロック後 | 変化 |
|---|---|---|---|
| 4Kプロンプトの読み込み | 2,896.8 | 3,153.9 | +8.9% |
| 16Kプロンプトの読み込み | 3,473.9 | 3,868.7 | +11.4% |
| 32Kプロンプトの読み込み | 3,534.0 | 3,961.2 | +12.1% |
| チャットの生成 | 143.3 | 144.6 | +0.9% |
| エージェント(5往復)の生成 | 148.3 | 151.2 | +2.0% |
| (公式ベンチ standard-v1)prompt-4k | 2,762.0 | 3,035.0 | +9.9% |
| (公式ベンチ standard-v1)prompt-16k | 3,409.2 | 3,792.7 | +11.3% |
(quick suite は3回の中央値。プロンプト読み込みの3回のばらつきは中央値から±1.5%以内)
prefillは長いプロンプトほど伸びて、32Kで+12.1%。行列演算単体の+60〜78%よりずっと小さいのは、prefillの中に行列演算以外の処理(アテンション、量子化された重みの展開、メインメモリからの転送など)が混ざっていて、速くなった部分の割合がそのぶん薄まるためです。生成(decode)は、メインメモリにあるエキスパートの転送が律速と考えられ、予想どおり変わりませんでした。
llama.cpp(Qwen3.8-27B 量子化モデル)— ほぼ0%
| テスト(tok/s) | stock | アンロック後 | 変化 |
|---|---|---|---|
| Q4_K_M prefill 512 / 4096 | 1,903.2 / 1,869.3 | 1,907.1 / 1,878.5 | +0.2% / +0.5% |
| Q4_K_M 生成 | 35.85 | 35.87 | +0.1% |
| Q5_K_M prefill 512 / 4096 | 1,833.4 / 1,817.2 | 1,840.3 / 1,826.6 | +0.4% / +0.5% |
| Q5_K_M 生成 | 31.53 | 31.57 | +0.1% |
| Q4_K_M 32Kの文脈があるとき prefill / 生成 | 1,386.3 / 31.53 | 1,408.0 / 31.30 | +1.6% / −0.7% |
普段使いのllama.cppではほぼ変化なしです。量子化モデルのprefillはllama.cppのMMQ(INT8のTensor演算)で計算されていて、INT8はもともと全速なのでアンロックの対象外。生成はメモリ帯域で決まります。32Kの文脈が埋まった状態でprefillが+1.6%と少しだけ伸びたのは、FlashAttentionのFP32累積部分が効いた可能性がありますが、誤差の範囲と区別できるほどではありません。
「普段のLLMチャットが速くなるか」という意味では、答えはNoです。前回の記事で書いたとおり、このカードの生成速度はメモリ帯域(716.8GB/s)で決まっていて、そこはアンロックでは動きません。
RTX 4090並みになる? — 一部だけ
| GPU | FP16/BF16 Tensor(FP32累積) | 備考 |
|---|---|---|
| RTX 4080(通常) | 公称 97.5 / 実測 100〜104 TFLOPS | 実測は今回のPC。ブーストクロックが公称より高いぶん上回る |
| RTX 4080(アンロック後) | 実測 156〜179 TFLOPS | 今回のPC。320Wの電力上限で頭打ち |
| RTX 4090(通常) | 公称 165.2 TFLOPS | NVIDIA公称値(理論値) |
この演算に限れば、アンロック後のRTX 4080は素のRTX 4090の公称値と同じくらいです。ただし4090は公称値(理論値)、4080は実測値なので、厳密な比較ではありません。そして、4090並みになるのは本当にこの部分だけです。
| 項目 | RTX 4080(アンロック後・このカード) | RTX 4090 | アンロックで変わるか |
|---|---|---|---|
| FP16/BF16/TF32/FP8(FP32累積) | 4090の公称値と同程度 | — | 向上 |
| FP16累積・INT8のTensor | 4080のまま | 約1.7倍 | 変わらない |
| FP32(CUDAコア) | 公称 約48.7 TFLOPS | 公称 約82.6 TFLOPS | 変わらない |
| メモリ帯域 | 716.8 GB/s | 1,008 GB/s | 変わらない |
| VRAM | 32GB(改造) | 24GB | — |
| 電力上限 | 320W | 450W | 変わらない(頭打ちの原因) |
まとめると、このカードは「BF16の行列演算は4090並み、メモリ帯域は4080のまま、VRAMは4090より多い32GB」という、ちょっと変わった組み合わせになります。
GPU unlockが使えるGPU一覧 — RTX 40シリーズの対応状況
今回のRTX 4080 32GBのほかに、どのGPUでGPU unlockが使えるのかをまとめました。対象はRTX 40シリーズ(Ada世代)で、公開されているツールの対応表と、Issue・PRで報告されている結果をもとにしています。ほとんどが「1枚で試して成功した」という段階で、型番が同じなら必ず動く、というものではありません。
| GPU | PCI ID(ダイ) | ツール | 状況(2026年10月25日時点) |
|---|---|---|---|
| RTX 4090 | 10de:2684(AD102) | gpu-unlock-ada(Linux) | 正式対応。FP16/BF16(FP32累積)が約2倍の報告。48GB改造品でも成功報告あり(Issue #21) |
| RTX 4090 D | 10de:2685(AD102) | gpu-unlock-ada(Linux) | 実験的対応(オプトイン) |
| RTX 4080 32GB改造品 | 10de:2704(AD103) | AD103_win_unlocker(Windows) | 作者の1枚と、この記事の1枚(移植版)で成功。カード個体とPCに合わせた値に固定 |
| RTX 4080(16GB) | 10de:2704(AD103) | gpu-unlock-ada(Linux・未マージのPR #9) | 実験的なPRのみ。通常の16GB版での成功報告は見当たらない |
| RTX 4070 Ti SUPER | 10de:2705(AD103) | gpu-unlock-ada(Linux) | 実験的対応(1枚で検証)。別のダイの10de:2689版はPR #19で、実機では未検証 |
| RTX 4070 Ti | 10de:2782(AD104) | Windows参考移植(MSI機1台)/Linux・PR #15 | MSI製カード+MSI Z490の1構成と、ASUS製カード1枚で成功報告 |
| RTX 4070 SUPER | — | Windows(UEFI版) | Issue #8 にスクリーンショット1枚の報告のみ。詳細は不明 |
| RTX 4070 | 10de:2786(AD104) | gpu-unlock-ada(Linux・未マージのPR #11) | 実験的なPR(コールドブートでの成功記録付き) |
| RTX 4060 Ti 16GB | 10de:2805(AD106) | gpu-unlock-ada(Linux) | 実験的対応(1枚で検証)。8GB版(別のID)は対象外 |
| RTX 4080 SUPER | — | — | 対応なし・成功報告なし(Issue #18 は質問のみ) |
なお、上流のLinux版はもともとRTX 3090などAmpere世代(GA102)向けのもので、RTX 3080やRTX 3070での成功報告もあります。
RTX 40シリーズのAmazonリンク
表の型番の商品をAmazonで探してみました。商品ページからはPCI IDやダイ、VBIOSはわかりません。たとえばRTX 4070 Ti SUPERには別のダイを使った版(10de:2689)があり、表の「実験的対応」に当たるのはAD103版(10de:2705)だけです。RTX 4080は通常の16GB版で、この記事の32GB改造品とは別物です。どれも新品の流通は少なくなっていて、2026年10月25日時点の価格はすべてマーケットプレイスの出品者のもの(発売時の価格より高め)でした。


向いている人・注意点
効果がありそうな用途
- BF16/FP16で学習やファインチューニングを回す(行列演算の割合が高い)※今回は未計測
- FP16/BF16の画像生成 ※今回は未計測
- 長いプロンプトを大量に読ませるLLMの使い方(Strataでprefill+9〜12%)
ほぼ意味がない用途
- 普段のLLMチャット(生成速度はメモリ帯域で決まる)
- llama.cppの量子化モデル(prefillはINT8、生成はメモリ帯域)
- ゲーム(グラフィックスはこの演算をほとんど使わないはず。未計測)
注意点
- 作者が明記しているリスク:起動しなくなる、画面が映らなくなる、データの破損、ハードウェアの損傷。保証は一切ありません
- 今回の移植は、このマザーボードとこのカードの組み合わせで1回成功しただけです。BAR0とSS1は、自分の環境でドライランして実測した値に合わせています。他の人の値を写しても意味がなく、別のマザーボードでは画面出力の扱いやUSBまわりなど、別の違いが出る可能性があります(作者も「定数を書き換えるだけでは検証済みの移植ではない」と書いています)
- 効果は永続しません。使うたびに、完全に電源を切ってからUSBで起動する必要があります
- 内蔵GPUを無効にして、RTX 4080で画面を出す構成にする必要がありました。Secure Bootも無効です
- まだ確かめていないこと:長時間の安定性、再起動(ウォームブート)後の挙動、電源を切ってstockに戻った後の再計測、PyTorchでの学習、画像生成、ゲーム
まとめ
RTX 4080 32GBの「GPU unlock」は、行列演算は確かに速くなるけど、その恩恵を受けるアプリは限られる、というのが今回の結論です。
- 配布版のEFIは、このPCではBAR0のアドレス(マザーボード側)とSS1の初期値(チップ個体)の2点で止まった。カードとROMの中身は作者と同じ
- 配布版を完全に再現できるツールチェーンで、4行だけ変えた移植版を作り、Windowsは普通に起動してアンロック成功
- BF16→FP32の行列演算は100.71→179.42 TFLOPS(+78.2%)、FP16→FP32は+69.6%。TF32とFP8も+40〜63%
- 大きな行列では320Wの電力上限でSMクロックが下がり、伸びは+53〜68%に縮む
- 計算結果は全57ケースでビット単位で一致
- LLMでは、Strata(125B MoE)のprefillが+9〜12%、生成速度とllama.cppの量子化モデルはほぼ変化なし
「このカードで普段のLLMが速くなるか」と聞かれたら、答えはNoです。一方で、BF16の行列演算を回す用途なら、32GBのVRAMと4090並みの行列演算が同居する、なかなか面白いカードになります。次は、効果が大きそうなのに今回は測れなかった、PyTorchでの学習や画像生成で確かめてみたいと思います。
検証ノート(再現用)
計測は2026年10月25日、同じマシン・同じドライバ(616.56)・同じスクリプトで実施しました。アンロックの前後で、表示構成(内蔵GPU無効・RTX 4080で表示)と開いているアプリをそろえています。
# 使ったリポジトリ
TOTORONG/AD103_win_unlocker  51df9c17ec89eb8486df52cc9079dde4bd1f9974(Hugging Face)
JustAResearcher/gpu-unlock-ada  4e7fefcc4923f9e083d5324dc75a7d2f906af77f(比較用の記録)
Niko1221/Strata  7dd5cf18(v0.2.4.2 とコード同一、エンジン 0.1.48)

# EFI のハッシュ(SHA-256)
配布版 v0.4.18          9f821b8e9fa11cd8e145908e6abcf36bd28bfe96a138ddc07365f1700338eb01
無改変ソースを再ビルド  9f821b8e9fa11cd8e145908e6abcf36bd28bfe96a138ddc07365f1700338eb01(一致)
移植版 v2(BAR0 + SS1)  49620079e3896862e7342f99491a0a699589d0fa9a29545f50fd2cd67128eb9d

# 資産ファイル(WSL2 Ubuntu, Python 3.14。NVIDIA 610.43.03 から手元で抽出。配布不可)
python3 -I tools/prepare_assets.py
git lfs pull --include="USB/RTX4080-EXPERIMENT/ASSETS/v67-ad102-610.43.03-four-plm.bin"

# EFI のビルド(Zig 0.14.1)
python -I build.py --zig zig-x86_64-windows-0.14.1\zig.exe

# 行列演算(作者の bench.py と同じ手順: NN、seed 123、warmup 20、7 batch × 30、FP64 で検算)
python gemm_bench.py --suite author   # N=4096/8192, FP32 / FP16→FP32 / BF16→FP32
python gemm_bench.py --suite sweep    # N=1024〜16384 × FP32/TF32/FP16/BF16/FP16累積/INT8/FP8 + LLMの形

# llama.cpp b10549
llama-bench -m <Qwen3.8-27B系 Q4_K_M / Q5_K_M>.gguf -ngl 999 -fa on -ctk q4_0 -ctv q4_0 -p 512,4096 -n 128 -r 3
llama-bench -m <Qwen3.8-27B系 Q4_K_M>.gguf -ngl 999 -fa on -ctk q4_0 -ctv q4_0 -p 4096 -n 128 -d 32768 -r 3

# Strata(公式ベンチと quick suite)
strata.py bench run --profile strata-iq2_xs.json --suite standard-v1 --track default
python tools/strata_bench.py --config strata-iq2_xs.json --long --runs 3
Strataの公式ベンチ(standard-v1)は、両フェーズとも21リクエストを完走し、サニティチェックも12/12で合格していますが、終了時にエンジンのプロセスを止められず、記録上は「FAILED」扱いになりました。表では参考値として載せ、本文の比較はquick suiteの値を中心にしています。
公開にあたって、ROMのダンプ、NVIDIAのファームウェア、GPUのUUIDなど個体を特定できる情報、移植版のEFIのバイナリは載せていません。
クレジット
- TOTORONG/AD103_win_unlocker(コードはGPL-2.0、解説文書はCC BY-NC 4.0)— 今回の移植の元。作者の公開値・手順を参照しました
- JustAResearcher/gpu-unlock-ada — 他のカードのSS0 / SS1の値、RTX 4070 Ti SUPERのFP8の結果、RTX 4070 TiのWindows移植の記録を参照しました
- Zagitta/gpu-unlock、NVIDIA open-gpu-kernel-modules、Nouveau、envytools — 上流の研究
それでは、また。
コメントを残す